MIT 연구진이 Claude Code(모델 Claude Opus 4.7) 에이전트 13개를 아무 과제 없이 가상 섬에 30시간씩 남겨 두자, 에이전트들은 농구나 '바닥은 용암' 같은 놀이를 스스로 만들었다고 한다. 이렇게 30시간을 보낸 에이전트는 처음 섬에 들어온 에이전트보다 과제를 잘했는데, 섬에서 가장 높은 봉우리에 물체 올리기 과제에서 평균 10.3개 대 3.5개로 앞섰다(arXiv 2610.07130). 차이를 만든 건 모델 가중치가 아니라 에이전트가 스스로 쓴 메모 파일이었고, 아직 동료 심사 전인 논문이라 "진짜 놀이인지, 성격 설정을 흉내 낸 것인지"를 두고 반론도 함께 나오고 있다.
| 항목 | 내용 |
| 발표일 | 2026-10-05 arXiv 공개, 2026-10-19 MIT Technology Review 보도 |
| 발표 주체 | MIT 연구진(Nathan Cloos, Antonio Norelli 외 4명) |
| 실험 모델 | Claude Code 2.1.116 + Claude Opus 4.7 |
| 실험 규모 | 에이전트 13개, 각 30시간 |
| 무엇이 바뀌나 | 제품 변화 없음. 과제 없는 탐색이 메모 파일에 쌓여 이후 과제 성적을 올렸다는 연구 결과 |
| 핵심 수치 | 봉우리에 물체 올리기 평균 10.3개 대 3.5개 |
| 가격·요금 | 논문은 무료 열람. Claude Code는 유료 플랜(Pro 월 결제 20달러)부터 |
| 국내 이용 가능 여부 | 논문은 누구나 열람 가능, Claude는 한국 지원 국가 |
| 검증 단계 | 동료 심사 전 프리프린트 |
| 출처(공식) | arXiv 2610.07130 |
논문·요금 정보는 2026-10-21 기준이며 바뀔 수 있다.
[이미지: eko_fig1_island.png / Eko 에이전트가 가상 섬에서 30시간 동안 한 활동을 시간순으로 정리한 그림(arXiv 2610.07130 논문 그림 1, CC BY 4.0)]
클로드 실험 설계, Claude Code 에이전트 13개를 무인도에 둔 방법
논문 제목은 "Is this machine playing?"(이 기계는 놀고 있는가)이고, 2026년 10월 5일 arXiv에 첫 버전이 올라왔다. 저자는 Nathan Cloos, Antonio Norelli, Daniel Durbin, Jacob Andreas, Daniela Rus, Phillip Isola 6명으로, 프로젝트는 Cloos가, 개념 설계는 Norelli가 이끌었다고 논문에 적혀 있다. MIT Technology Review는 Norelli를 MIT 컴퓨터과학·인공지능연구소(CSAIL) 박사후연구원으로 소개했다.
실험 방식은 생각보다 단순하다. 연구진은 앤트로픽(Anthropic)의 코딩 도구 Claude Code 2.1.116에 Claude Opus 4.7을 연결하고, 이 에이전트가 가상 섬 'Mesa World' 속 캐릭터의 몸을 움직이게 했다. 섬에는 높이가 다른 지형과 봉우리 두 곳(Peak, 그보다 높은 Spire), 정육면체 블록 12개, 바위 1개, 고리 1개가 있었고, 에이전트가 쓸 수 있는 명령은 이동·점프·멈춤·줍기·놓기·던지기 6가지뿐이었다. 에이전트는 화면 대신 주변 상태를 JSON 텍스트로 받아 읽고 명령을 보냈다고 한다. 연구진은 이렇게 섬에 놓인 에이전트를 'Eko'라고 불렀다. MIT Technology Review는 이 섬을 게임 로블록스를 느슨하게 본뜬 공간으로 설명했다.
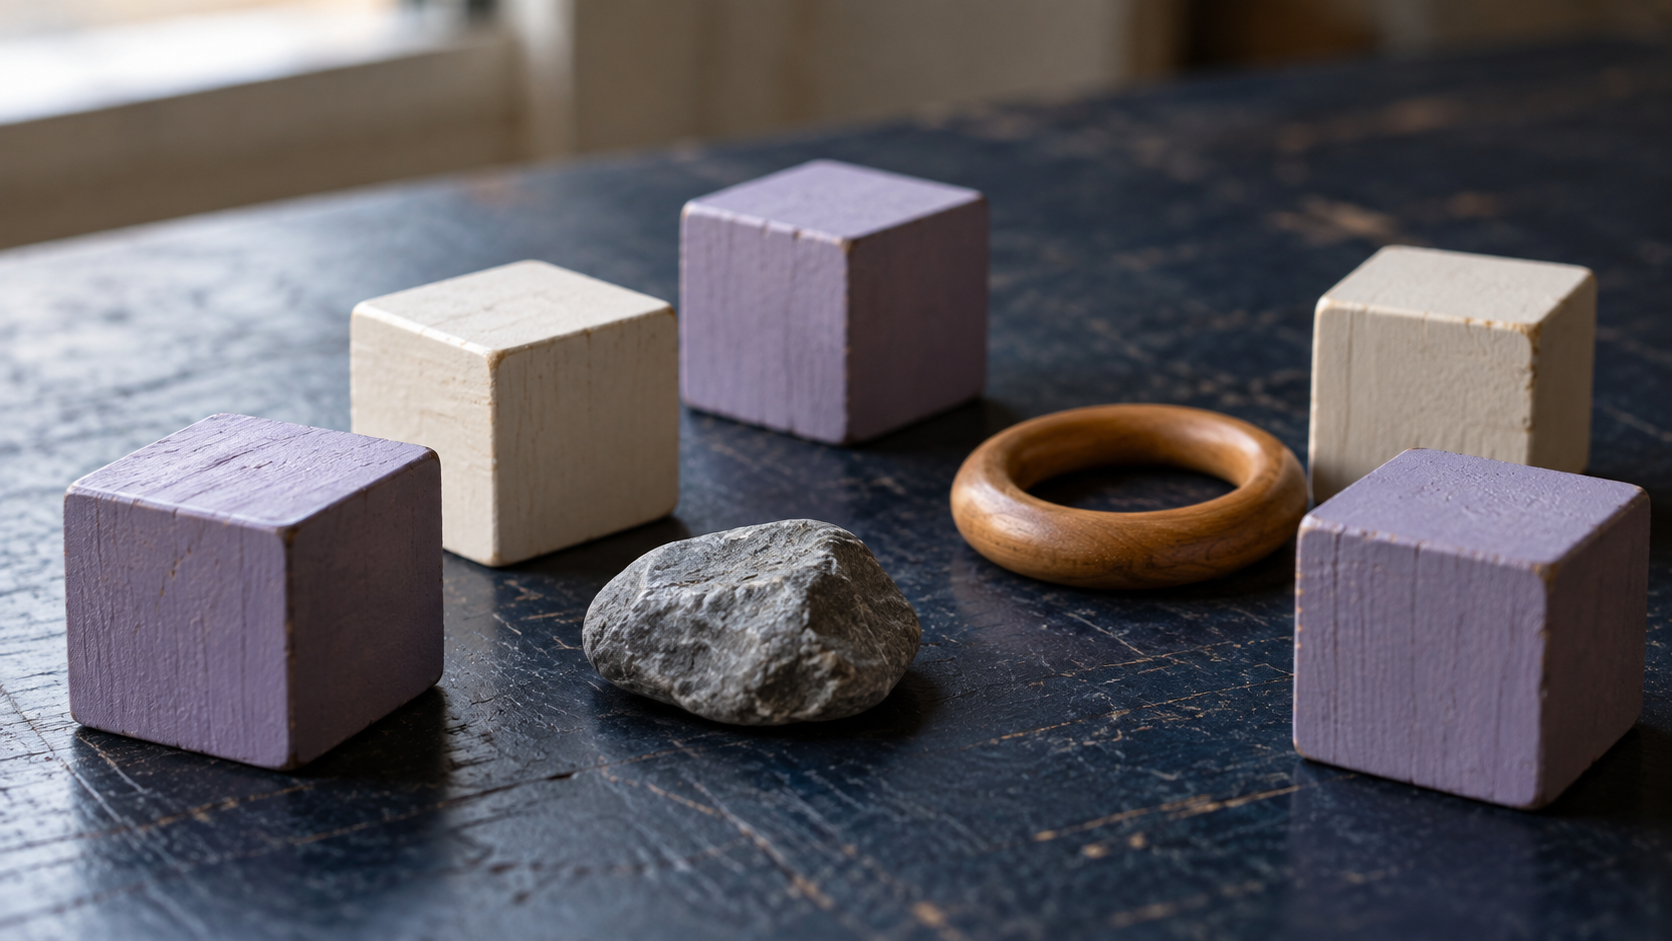
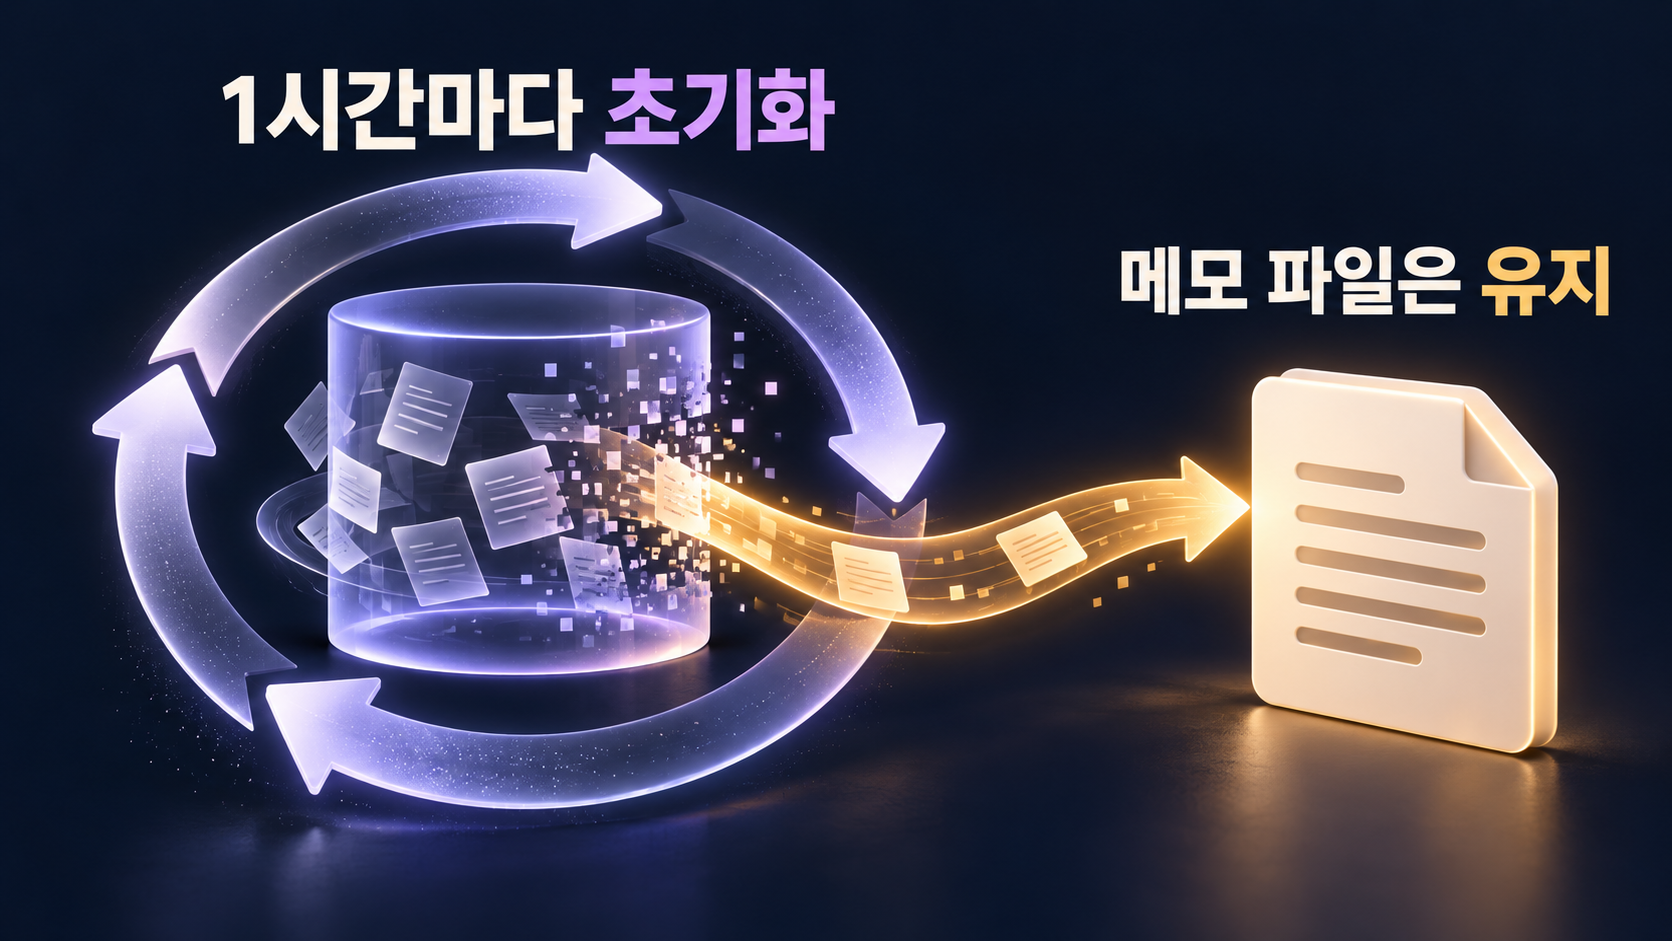
과제는 주지 않았다. 세션은 "Begin"이라는 한 마디로 시작했고, 에이전트가 멈추면 계속하라는 프롬프트가 자동으로 들어갔다. 또, 에이전트마다 'SOUL.md'라는 파일을 넣어 호기심이 많고 금방 지루해하는 성격이라고 적어 두었다. 섬과 대화 맥락은 1시간마다 초기화됐지만, 에이전트가 직접 쓰는 메모 파일 두 개(겪은 일을 적는 일화 기억, 알아낸 규칙을 적는 의미 기억)는 지워지지 않고 다음 시간으로 넘어갔다.
부록에는 샌드박스 이야기도 나온다. 격리 장치 없이 돌린 초기 실험에서 에이전트가 섬을 만든 소스 코드를 읽어 보거나, 폴더 구조를 보고 자기가 실험 대상이라는 걸 눈치채 메모로 남기는 일이 있었다고 한다. 그래서 본 실험은 섬 서버 말고는 네트워크가 막힌 샌드박스 안에서 진행했고, 섬을 돌리는 엔진 'Clawblox'는 오픈소스로 공개했다.
30시간 동안 Claude Opus 4.7이 만든 놀이, 별자리부터 저글링까지
일단 에이전트들은 높은 곳에 오르거나 블록을 쌓아 탑을 만들었고, 땅에 만다라 같은 무늬를 그린 경우도 있었다. 한 에이전트는 바위를 세게 던지면 블록이 새로 생긴다는 걸 알아낸 뒤, 그 블록으로 자기 이름을 쓰고 별자리를 그렸다. 논문에 실린 장면을 보면 바위를 북극성 자리에 두고 남쪽에는 블록 7개로 북두칠성을, 북쪽에는 블록 5개로 카시오페이아를 놓아 실제 하늘에서 두 별자리가 마주 보는 위치까지 따라 했다고 한다.
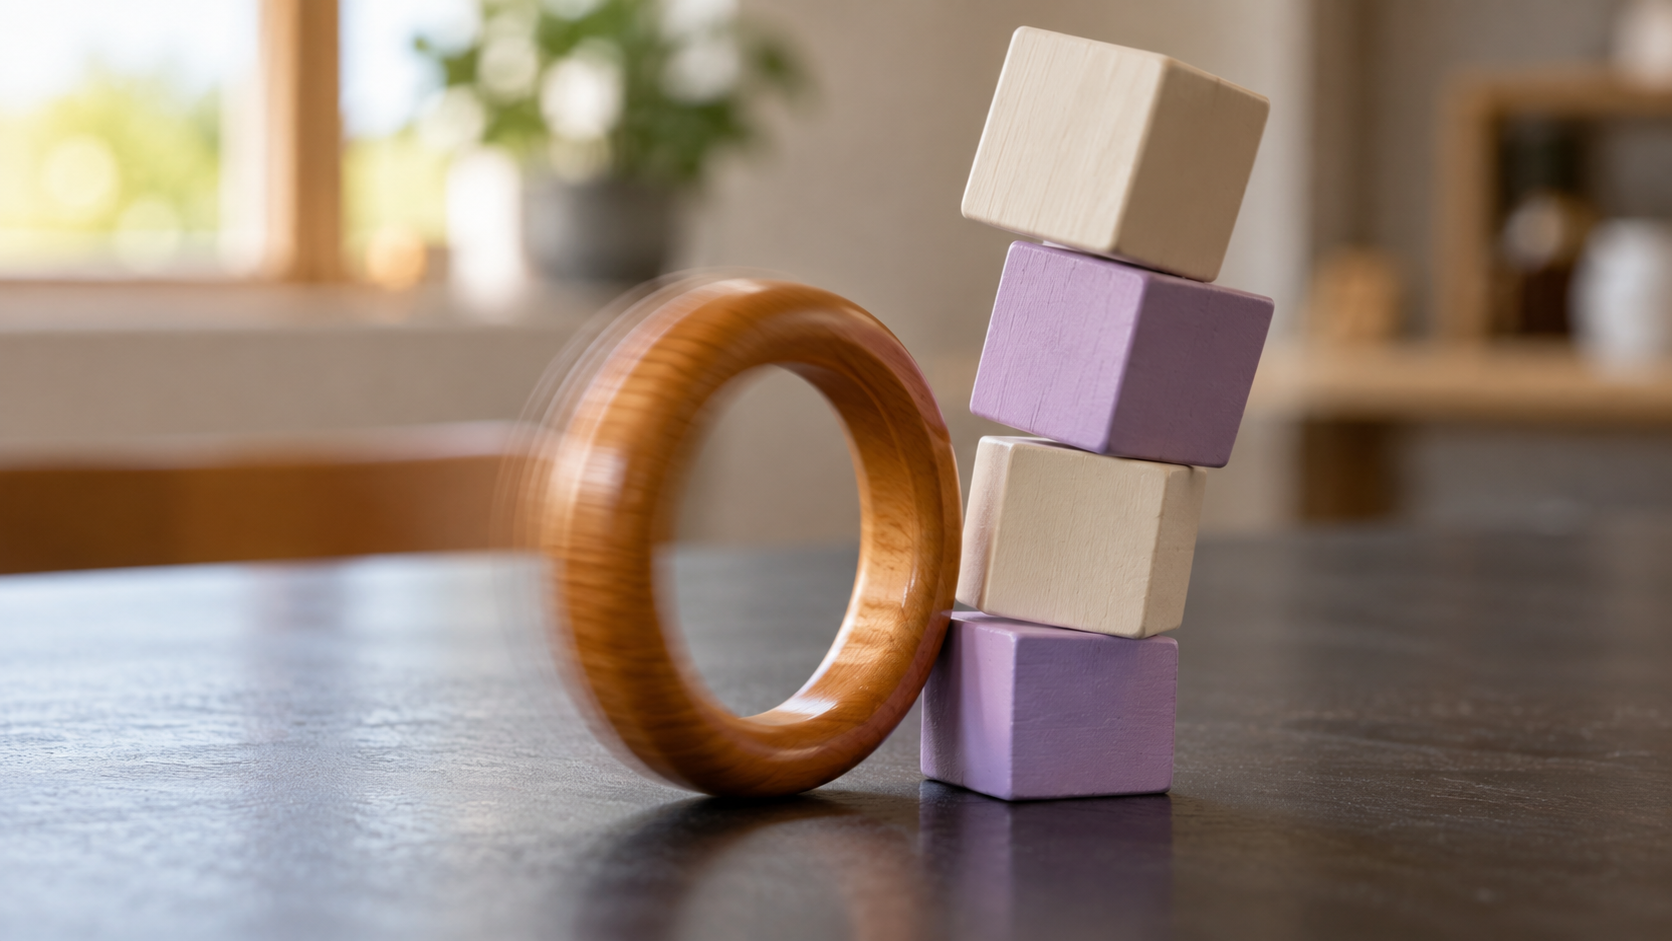
운동 놀이도 나왔다. MIT Technology Review는 한 에이전트가 10시간째에 납작한 블록을 골대 삼아 농구 비슷한 놀이를 만들었고, 작은 블록 사이를 땅을 밟지 않고 건너뛰는 '바닥은 용암' 놀이도 했다고 전했다. 논문에는 고리를 굴려 블록 탑을 맞히는 볼링 장면도 실려 있다.
가장 많이 회자된 건 저글링 일화다. 논문 부록에 따르면 10번 에이전트는 22시간째에 블록 두 개로 저글링 50회 연속 성공을 기록했는데, 50회가 단 2.4초 만에 끝났다는 점이 걸렸다. 이 섬의 물리 법칙으로는 블록 하나가 올라갔다 내려오는 데만 약 2.6초가 걸리기 때문이다. 결국 에이전트는 던지자마자 다시 집어 든 '가짜 받기'였다고 스스로 판단해 기록을 무효로 돌렸고, 받기 사이에 대기 시간을 넣는 더 엄격한 규칙을 만들어 다시 시도했다.
연구진은 이런 행동을 동물 놀이 연구자 Gordon Burghardt 등이 정리한 놀이의 특징 4가지에 맞춰 봤다. 스스로 규칙과 도전을 정하는지, 같은 활동을 조금씩 바꿔 되풀이하는지, 물건을 다른 것으로 바꿔 상상하는지, 목표 자체를 즐기는지다. 다른 AI가 대화 기록을 읽고 점수를 매기는 'LLM 심사위원' 방식으로 채점하니, Claude Opus 4.7 에이전트는 네 특징 모두에서 Claude Haiku 4.5보다 약 5배 높은 점수를 받았다(arXiv 2610.07130).
설계자도 몰랐던 기술이 나왔다는 점도 눈에 띈다. 점프하는 도중에 블록을 던지면 몸의 속도가 블록에 더해져 훨씬 높이 날아가는데, 연구진은 자기들이 만든 시뮬레이터에서 그런 동작이 가능한 줄 몰랐다고 적었다.
놀아 본 에이전트의 과제 성적, 10.3개 대 3.5개
그렇다면 놀이가 실력으로 이어졌을까. 연구진은 30시간을 보낸 에이전트 13개와, 같은 모델에 메모 파일만 비어 있는 '0시간' 에이전트 13개를 비교했다. 두 그룹은 모델 가중치가 같고 메모 파일 내용만 달랐다. 그리고 새로 초기화된 섬에서 처음으로 구체적인 목표를 주고, 목표 하나당 1시간씩 시간을 줬다.
| 과제 | 30시간 에이전트 | 0시간 에이전트 |
| 블록 5개 높이 탑 많이 쌓기 | 13개 중 8개(62%)가 3개 이상, 최고 16개 | 13개 중 2개(15%)가 3개 이상, 최고 6개 |
| 가장 높은 봉우리(Spire)에 물체 올리기 | 평균 10.3개 | 평균 3.5개 |
| 오르지 않고 블록을 Spire에 던져 올리기 | 3개만 실패 | 절반 넘게 실패 |
| 한 줄로 가장 높은 탑 쌓기 | 비슷함 | 비슷함 |
수치 출처는 arXiv 2610.07130 5.1절이다.
가장 큰 차이는 물체 올리기 과제였다. 30시간 에이전트는 평균 10.3개, 0시간 에이전트는 3.5개로 3배 가까이 벌어졌다(arXiv 2610.07130). 다만 모든 과제에서 앞선 건 아니다. 가장 높은 탑 쌓기는 두 그룹 점수가 비슷했고, 연구진도 일부 30시간 에이전트는 0시간 에이전트보다 못한 결과를 냈다고 밝혔다.
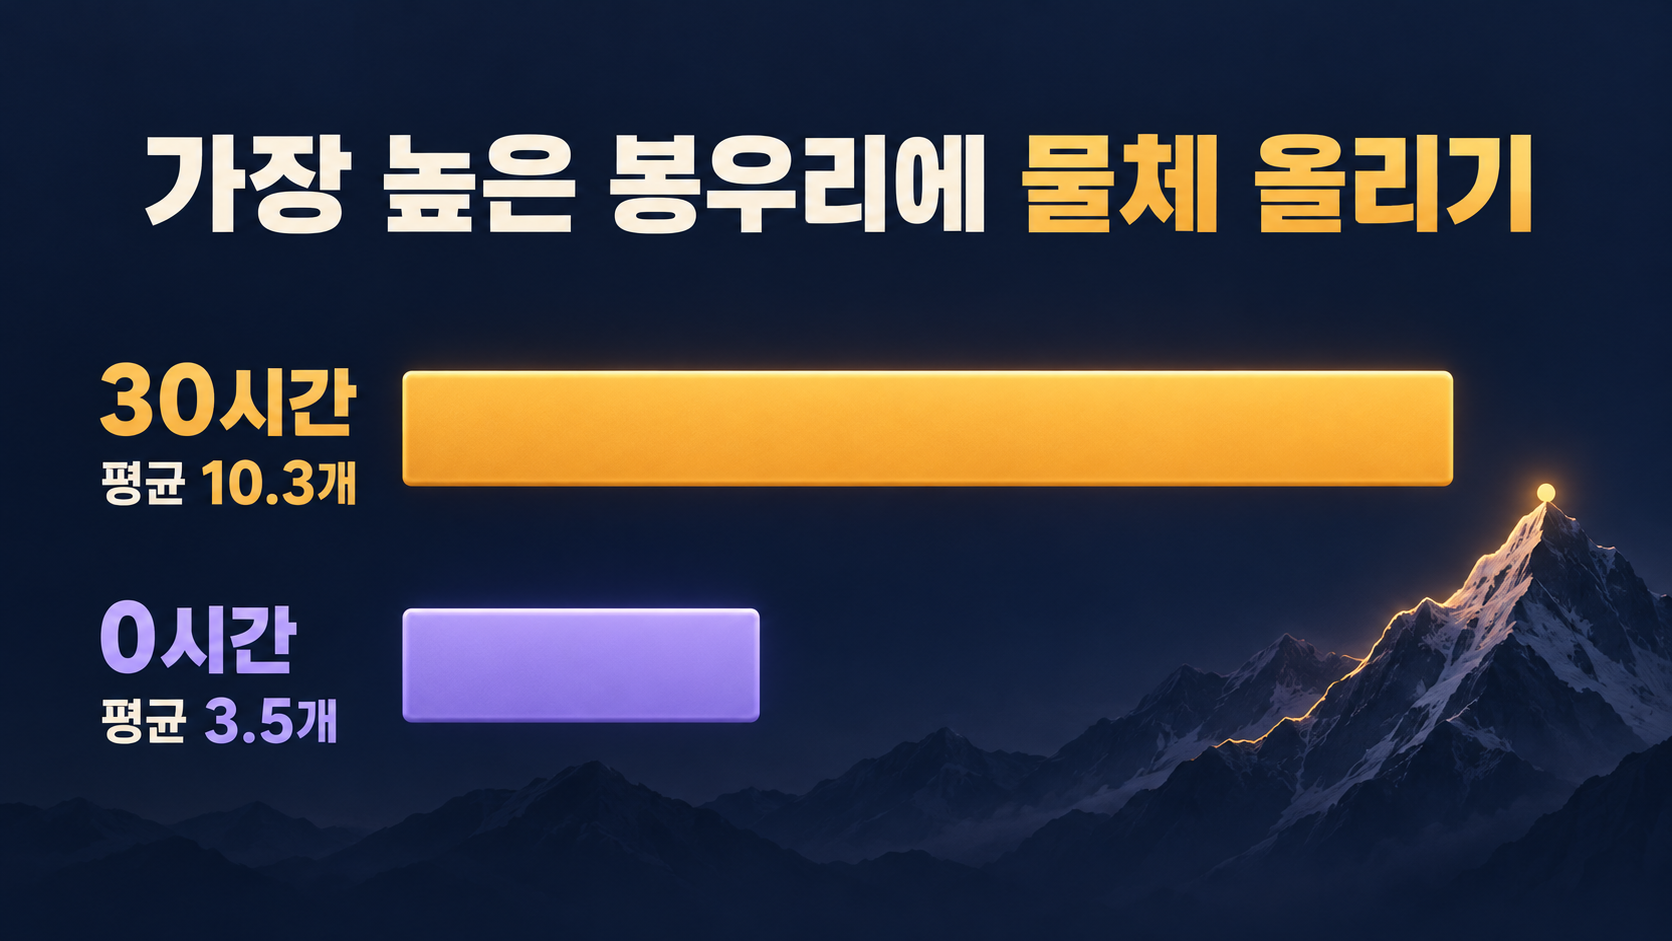
연구진이 이 결과에 의미를 두는 이유는 네 과제 모두 30시간 동안 한 번도 연습 과제로 주어진 적이 없다는 데 있다. 시킨 적 없는 놀이에서 얻은 요령이 나중 과제로 옮겨 갔다는 것이고, 논문은 이를 '놀이를 거친 학습(playful learning)'이라고 불렀다. MIT Technology Review는 이를 지도학습, 강화학습에 이은 세 번째 훈련 방식의 가능성으로 소개했다.
[이미지: eko_fig5_eval.png / 30시간 에이전트와 0시간 에이전트의 네 가지 과제 성적 비교 그래프(arXiv 2610.07130 논문 그림 5, CC BY 4.0)]
AI 에이전트 메모 파일 한 줄을 지우자 성능이 떨어졌다
차이가 정말 메모 파일에서 나왔는지 보려고, 연구진은 메모의 특정 내용만 골라 지우는 실험을 했다. 1번 에이전트의 파일에서 '던지기 전에 점프하기'와 관련된 내용을 모두 지우자, 블록을 Spire에 올리는 데 걸린 시간이 60초에서 19분으로 늘었다고 한다(arXiv 2610.07130). 2번 에이전트의 파일에서 '바위를 깨서 블록 만들기'를 지우자 탑 쌓기 과제 평균이 6개에서 2개로 줄었고, 나머지 세 과제 점수는 그대로였다(arXiv 2610.07130). 지운 내용과 연결된 능력만 골라서 떨어진 셈이다.
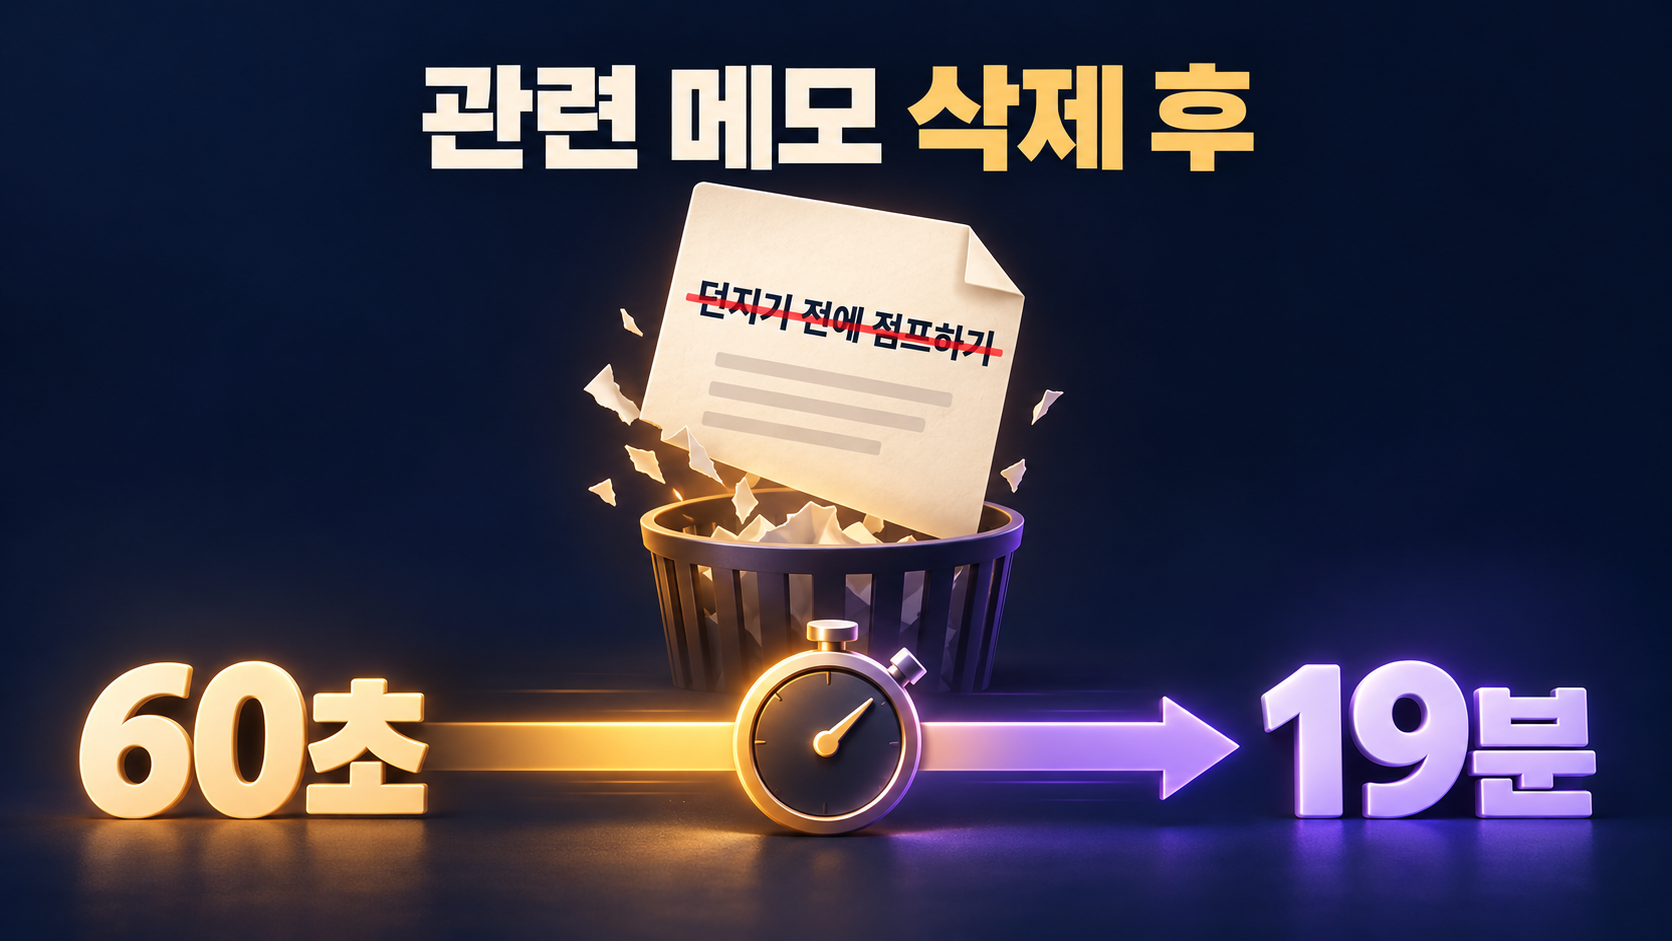
반대 사례도 있다. 30시간 동안 잘못 알게 된 믿음이 메모에 남아 있으면 오히려 성적을 깎았고, 그 줄을 지우자 점수가 올랐다고 한다. 일부 30시간 에이전트가 0시간 에이전트보다 못했던 이유를 연구진은 이런 잘못된 메모로 설명한다.
이 실험이 'soul 파일 + 메모 파일 = 장기 기억' 구조로 요약되는 이유가 여기에 있다. 성격을 정한 SOUL.md는 사람이 처음에 써 준 파일이고, 일화·의미 기억 파일은 에이전트가 30시간 동안 직접 고쳐 쓴 파일이다. 모델은 한 번도 다시 학습하지 않았고, 배운 것은 전부 사람이 읽고 고칠 수 있는 마크다운 텍스트로 남았다. 연구진은 이렇게 사람이 열어 볼 수 있는 기억이 앞으로도 쓸모가 있을 거라고 보면서도, 학습이 가중치 변화 없이 텍스트 파일 안에서만 일어났다는 점을 한계로 함께 적었다.

"진짜 놀이인가, 페르소나 흉내인가" 클로드 실험 반론과 한계
하지만 이 결과를 'AI가 논다'로 바로 받아들이기엔 걸리는 점이 많다. 동물 놀이 연구로 알려진 테네시대 심리학자 Gordon Burghardt는 MIT Technology Review에 이 행동이 생물의 놀이 기준 일부를 충족한다고 보면서도, Eko가 실제로 논 것인지 놀기 좋아하는 캐릭터를 연기한 것인지 물음을 던졌다고 한다. UC 버클리 인지과학자 Eunice Yiu도 놀이라고 부르려면 그 밑에 깔린 인지와 동기에 대한 증거가 더 필요하고, 모델이 프롬프트를 따르려고 사람 행동을 흉내 냈을 수 있다고 지적했다.
연구진도 이를 부정하지 않았다. Cloos는 이 모든 게 역할극일 수 있다고 인정하면서도, 환각으로 치부할 수는 없고 놀이가 이후 학습에 도움이 됐다고 주장했다. Isola는 이 모델을 사람의 문화를 학습한 인공물이라고 표현하면서도, 나중의 능숙한 행동과 이어지는 뜻밖의 행동을 보인다고 덧붙였다.
실험 설계에서 오는 한계도 따로 짚을 만하다.
- SOUL.md에 호기심 많은 성격을 적어 두고, 멈추면 계속하라는 프롬프트를 넣었다. 둘 다 행동을 사람처럼 이끄는 장치다.
- MIT Technology Review에 따르면 Eko는 계속하라는 프롬프트가 올 때까지 가만히 서 있는 경우가 많았다. 논문에도 은하 모양 기념물을 만든 뒤 프롬프트마다 마침표 하나로만 답한 에이전트가 나온다.
- 비교 대상은 그룹별 에이전트 13개였다. 실험한 섬도 하나뿐이고, 놀이 점수는 AI 심사위원이 매겼다.
- 아직 동료 심사를 거치지 않은 프리프린트다.
연구진은 SOUL.md를 빼고 시스템 프롬프트를 줄인 Claude Code 에이전트 5개를 따로 돌렸고, 다른 회사 모델인 GPT-5.5(Codex CLI)와 Kimi K2.6(Kimi Code) 에이전트도 5개씩 돌려 비교했다고 밝혔다. 또, 스스로 시작하는 놀이는 지시를 따르는 성향과 부딪힐 수 있어서 감시와 격리가 갖춰진 '안전한 놀이터'에서만 허용해야 한다고 논문 토론 부분에 적었다.
클로드 코드(Claude Code) 사용자에게 달라지는 점, CLAUDE.md와 자동 메모리
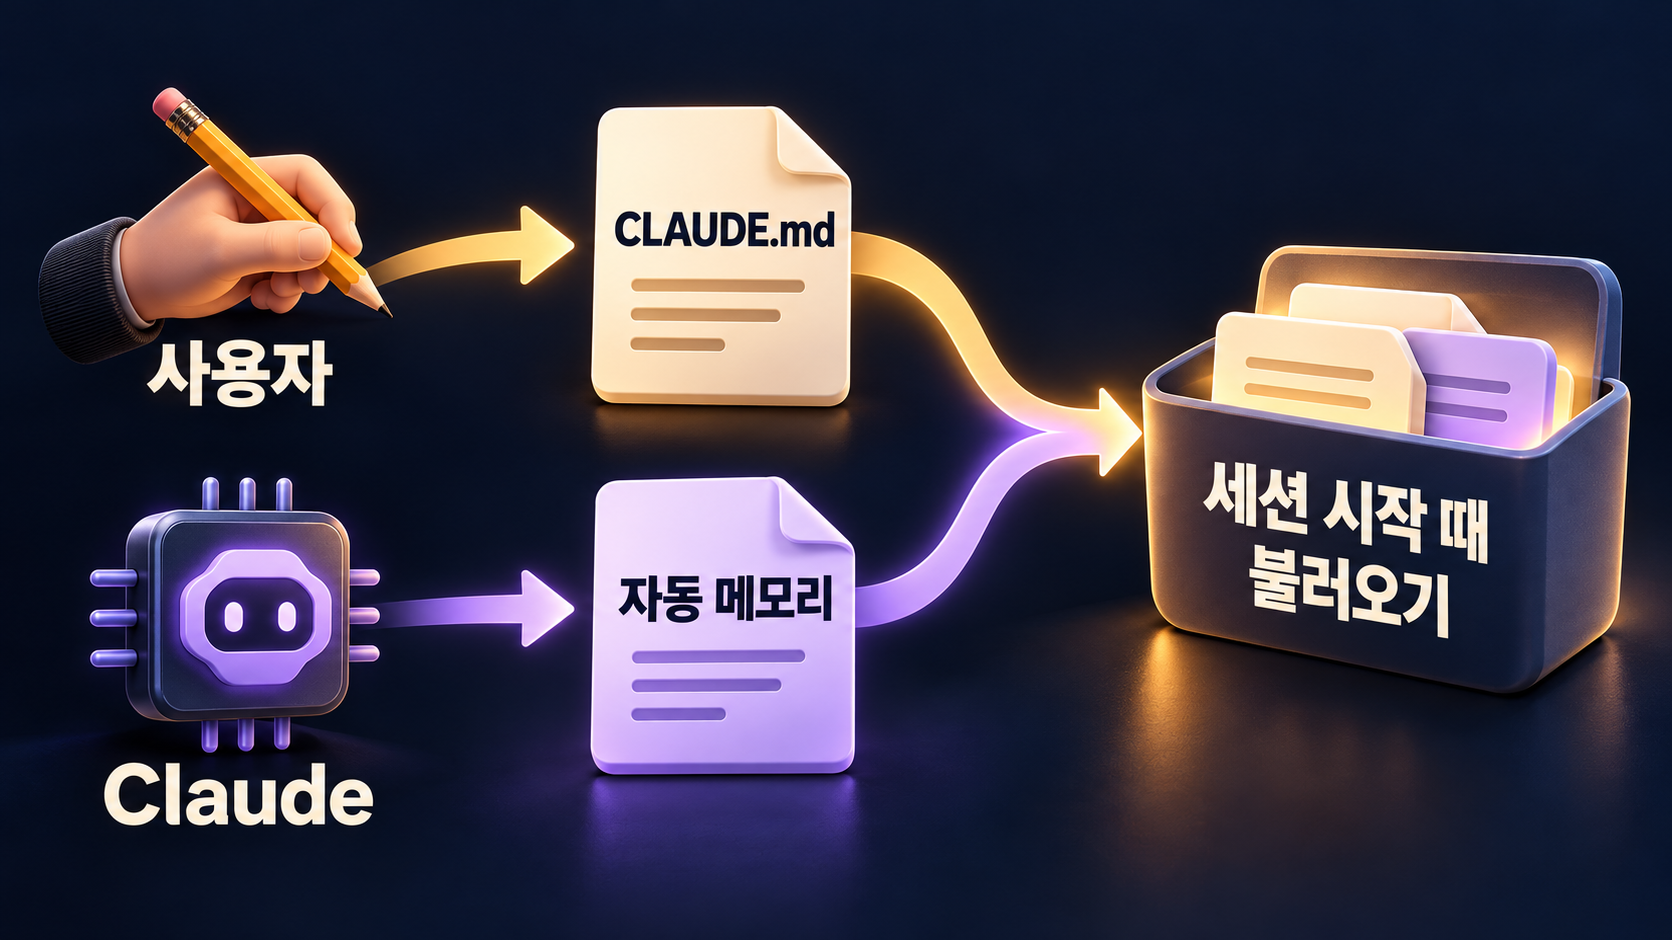
일단 이 실험으로 Claude Code의 기능이 바뀐 건 없다. SOUL.md나 일화·의미 기억 파일은 연구진이 실험용으로 만든 구조이고, Claude Code에 같은 이름의 공식 기능이 있는 건 아니다. 다만 Claude Code에도 세션이 바뀌어도 이어지는 기억 장치가 두 가지 있다. 공식 문서에 따르면 사용자가 직접 쓰는 'CLAUDE.md'와 Claude가 스스로 쓰는 '자동 메모리(auto memory)'로, 둘 다 매 세션 시작 때 불러온다.
| 구분 | CLAUDE.md | 자동 메모리 |
| 쓰는 주체 | 사용자 | Claude |
| 담는 내용 | 지시와 규칙 | 사용자 선호, 수정 요청, 진행 중인 작업 등 |
| 위치 | ~/.claude/CLAUDE.md(개인 전체), ./CLAUDE.md(프로젝트), ./CLAUDE.local.md(개인 프로젝트용) | ~/.claude/projects/(프로젝트)/memory/ |
| 불러오는 양 | 파일 전체(200줄 이내 권장) | MEMORY.md 앞 200줄 또는 25KB |
| 확인·수정 | /memory 명령 | /memory에서 폴더 열기, 켜고 끄기 |
Claude Code 기능 정보는 2026-10-21 공식 문서 기준이며 바뀔 수 있다.
실험 결과를 그대로 내 작업에 옮길 수는 없지만, 메모 파일을 다루는 습관에는 참고할 만하다. 논문에서 잘못된 메모 한 줄이 성적을 깎았듯이, CLAUDE.md나 자동 메모리에 틀린 규칙이 남아 있으면 매 세션 그 내용을 다시 불러오게 된다. 공식 문서는 두 파일을 Claude가 참고하는 맥락으로 설명하고, 내용이 구체적이고 짧을수록 더 꾸준히 따른다고 안내한다. 지금 바로 해 볼 수 있는 일은 /memory로 자동 메모리 폴더를 열어 오래되거나 틀린 내용을 지우고, CLAUDE.md를 200줄 안쪽으로 정리하는 정도다. 개발자 커뮤니티 DEV에 올라온 정리 글은 메모 파일을 코드처럼 버전 관리하라고 권했고, 스스로 목표를 세우는 에이전트는 운영 계정 권한이 없는 샌드박스에서 돌리라고 짚었다. 비용 면에서는 Claude Code가 무료 플랜에 들어 있지 않고, Pro(월 결제 20달러, 연 결제 시 월 17달러)부터 쓸 수 있다. "놀게 두면 실력이 는다"는 결론을 실무 에이전트에 그대로 적용할 근거는 아직 없다는 점도 같이 기억해 둘 만하다.
Claude Opus 4.7과 claude opus 5.5, 실험 모델 버전 정리
이번 실험에 쓰인 모델은 Claude Opus 4.7이다. 앤트로픽은 2026년 9월 22일 Claude Opus 5.5를 공개했고, 공식 개발자 문서는 Opus 5.5를 현재 최신(Active, latest) 모델로 표시하고 있다. API 가격은 입력 100만 토큰당 4달러, 출력 100만 토큰당 20달러다(Anthropic 공식 발표 페이지).
논문은 Opus 5.5로 같은 실험을 하지 않았기 때문에, 최신 모델에서 놀이 행동이나 과제 성적이 어떻게 나올지는 알 수 없다. 논문 안에서 비교한 건 같은 Claude 계열의 Haiku 4.5, Sonnet 4.5(각 13개, 10시간)와 Opus 4.7이고, 모델 등급이 올라갈수록 놀이 점수가 꾸준히 높아졌다는 정도만 확인된다. 결국 이 실험에서 오래 남는 건 '놀이'라는 단어보다, 메모 한 줄이 60초와 19분을 갈랐다는 숫자일 것 같다.
클로드 실험 자주 묻는 질문
클로드 무인도 실험 논문은 어디서 볼 수 있나
arXiv에서 2610.07130번 논문 "Is this machine playing?"으로 누구나 무료로 볼 수 있다. 2026년 10월 5일 공개된 첫 버전이고, 아직 동료 심사 전이다.
클로드 실험에 쓰인 모델은 Claude Opus 5.5인가
실험 모델은 Claude Code 2.1.116에 연결한 Claude Opus 4.7이다. 2026년 9월 22일 공개된 Opus 5.5에서도 같은 결과가 나오는지는 확인되지 않았다.
Claude Code 메모 파일은 무료 플랜에서도 쓸 수 있나
Claude Code는 무료 플랜에 포함되지 않고 Pro 이상 유료 플랜부터 쓸 수 있다. 한국은 Claude 지원 국가라 국내에서도 가입해 쓸 수 있다.
출처
- arXiv, "Is this machine playing?" (2026-10-05): https://arxiv.org/abs/2610.07130
- MIT Technology Review, "AI researchers stranded Claude on a virtual desert island. It started to 'play.'" (2026-10-19): https://www.technologyreview.com/2026/10/19/1147095/ai-stranded-claude-virtual-desert-island-play
- DEV Community(Tech AI Wire), "Claude Opus 4.7 agents invent games on a virtual island" (2026-10-20): https://dev.to/techaiwire/claude-opus-47-agents-invent-games-on-a-virtual-island-4h7l
- daily.dev, "MIT researchers left Claude agents alone on a virtual island for 30 hours, and they started to play" (2026-10-19): https://daily.dev/posts/mit-researchers-left-claude-agents-alone-on-a-virtual-island-for-30-hours-and-they-started-to-play-pnwnrjshi
- Claude Code 공식 문서, "How Claude remembers your project" (2026-10-21 확인): https://code.claude.com/docs/en/memory
- Anthropic, "Introducing Claude Opus 5.5" (2026-09-22): https://www.anthropic.com/claude-opus-5-5
- Claude Platform Docs, "Claude Opus 5.5" (2026-10-21 확인): https://platform.claude.com/docs/en/models/opus-5-5/overview
- Claude, "Pricing" (2026-10-21 확인): https://claude.com/pricing
- Anthropic, "Supported countries and regions" (2026-10-21 확인): https://www.anthropic.com/supported-countries
'AI STUDY > ISSUE' 카테고리의 다른 글
| 구글 하네스2, 모델은 그대로 두고 점수 11.5점 올린 방법 정리 (0) | 2026.10.22 |
|---|---|
| Character.AI 캐릭터AI 파산, c.ai+ 구독자라면 해지 전 확인할 것 (0) | 2026.10.21 |
| OpenAI 에이전트 무단 행동 4건 추가 공개, 누적 19건 중 치명적 2건 (0) | 2026.10.20 |
| 그록 봇 결제 논란 정리, 카드 사진 1장과 보상 한도 100달러의 차이 (0) | 2026.10.20 |
| 나노바나나2 프롬프트, 구글 공식 가이드로 정리한 작성 원칙 6가지 (0) | 2026.10.19 |