2026년 9월 10일, 코그니션(Cognition)이 자체 코딩 모델 SWE-2를 공개했다. 자율 개발 에이전트 '데빈(Devin)'을 만든 그 회사다. 이번 모델의 핵심은 성능 신기록이 아니다. 같은 문제를 훨씬 적은 비용으로 푼다는 쪽에 초점이 맞춰져 있다.
AI 코딩 도구를 실제 업무에 붙여본 사람이라면 이 방향이 왜 중요한지 안다. 요즘 문제는 "모델이 이 버그를 고칠 수 있는가"가 아니라 "고치는 데 토큰을 얼마나 태우는가"다. 에이전트가 파일을 100번 열어보고 테스트를 40번 돌리면 결과가 맞아도 청구서가 감당이 안 된다. SWE-2는 정확히 그 지점을 공략했다.
1. 베이스 모델은 Kimi K3
SWE-2는 처음부터 만든 모델이 아니다. 문샷AI(Moonshot AI)의 Kimi K3를 포스트트레이닝한 모델이다. K3는 2.8조(2.8T) 파라미터 규모이고, 이미 에이전틱 코딩을 대상으로 상당한 강화학습을 거친 상태의 베이스다.
이 선택 자체가 업계 흐름을 보여준다. 프런티어 성능을 내는 데 반드시 파운데이션 모델을 직접 사전학습할 필요가 없어졌다. 고성능 오픈웨이트 베이스를 가져와 자기 제품의 사용 패턴에 맞춰 후속 학습하는 쪽이 훨씬 자본 효율적이다. 데이터·워크로드·평가 환경을 이미 보유한 애플리케이션 기업에게는 특히 그렇다. 코그니션은 데빈을 운영하며 쌓은 실제 에이전트 실행 궤적을 갖고 있고, 그게 이번 모델의 가장 큰 자산이다.
코그니션은 강화학습 단계가 여러 벤치마크에서 베이스 대비 5~6포인트를 더했다고 밝혔다. 즉 베이스를 그대로 쓴 게 아니라, 후속 학습이 실질적인 성능 기여를 했다는 주장이다.
2. 벤치마크 — '이겼다'가 아니라 '따라붙었다'
공개된 수치는 다음과 같다.
| 벤치마크 | SWE-2 | Fable 5.1 | GPT-6 Astra |
| FrontierCode 1.1 (Main) | 50.0% | 50.9% | 53.3% |
| DeepSWE 1.1 | 73.0% | 67.4% | 74.1% |
| Terminal-Bench 2.1 | 92.8% | 91.4% | 89.9% |
| Terminal-Bench 4 | 27.3% | 55.8% | 57.9% |
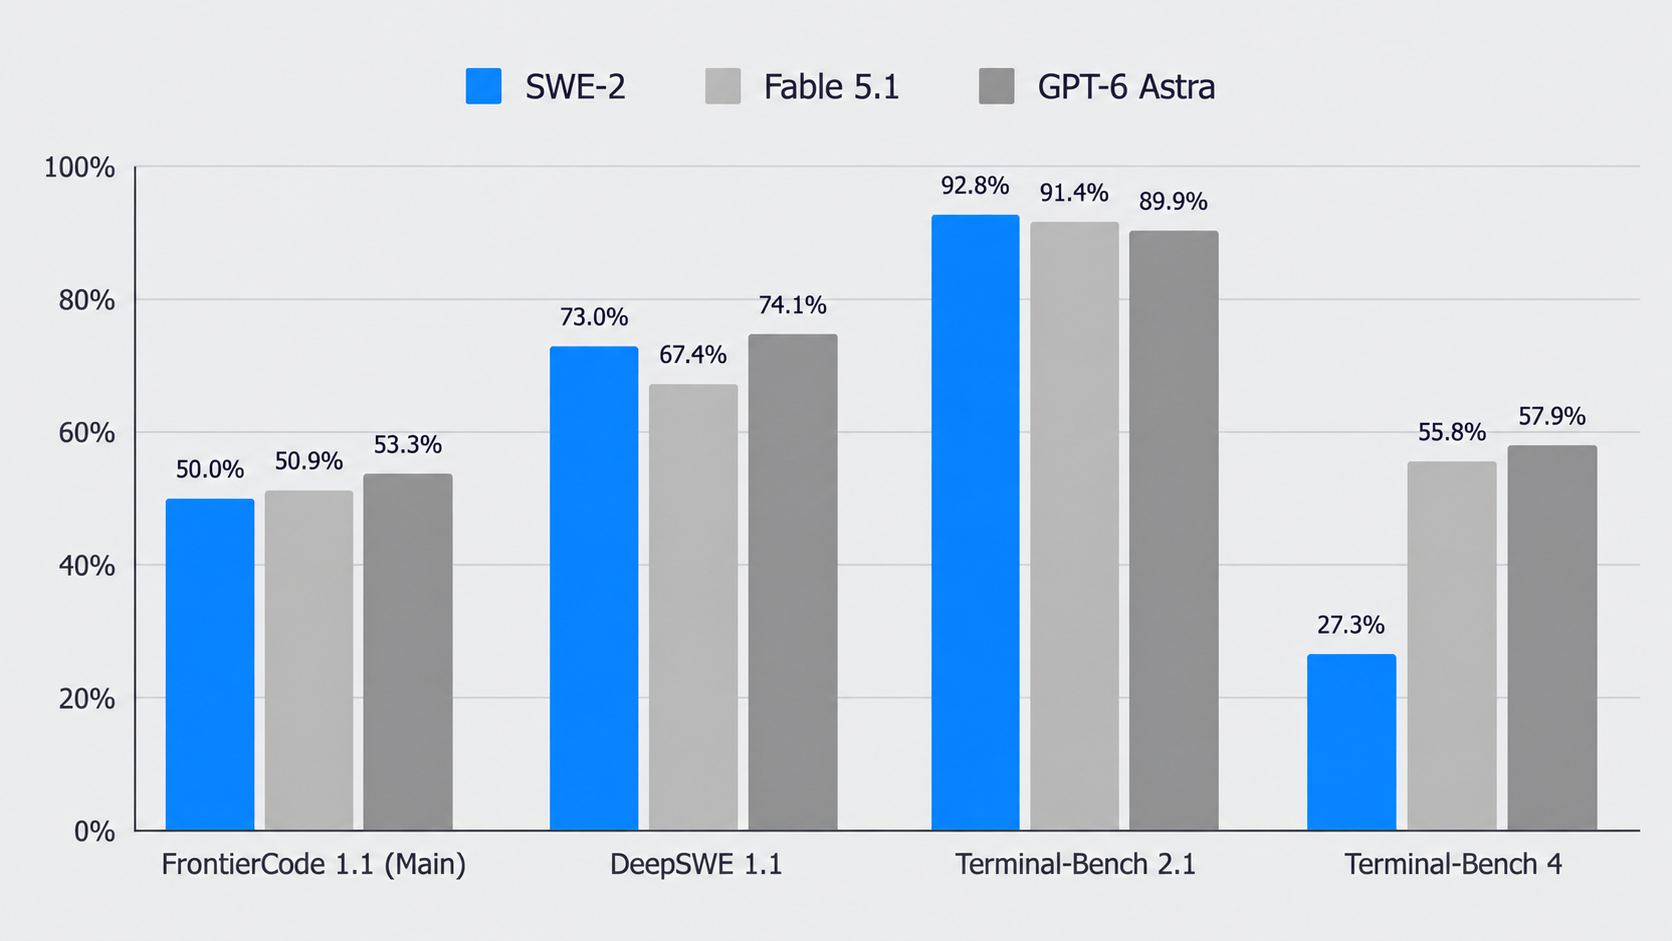
읽는 법이 중요하다.
- FrontierCode 1.1에서는 최상위권과 거의 붙었다. 0.9포인트 차이는 벤치마크 분산 범위 안이다.
- Terminal-Bench 2.1에서는 두 경쟁 모델을 모두 앞섰다.
- 그런데 Terminal-Bench 4에서는 27.3%로 크게 밀린다. 55~58%대인 경쟁 모델과 두 배 차이다.
마지막 줄을 그냥 넘기면 안 된다. Terminal-Bench 4는 더 길고 복잡한 터미널 작업을 다루는 최신 세대 평가다. 여기서 벌어진 격차는 SWE-2가 잘하는 구간과 못하는 구간이 뚜렷하게 나뉜다는 뜻이다. 표준적이고 반복적인 코드 수정 작업에는 강하지만, 긴 호흡의 비정형 작업에서는 아직 상위 모델을 대체하기 어렵다고 읽는 게 정직하다.
코그니션이 마케팅 문구로 앞세운 것은 "Fable 5.1과 대등한 성능을 64% 낮은 비용으로"다. 이 문장은 FrontierCode 기준으로는 타당하지만, 모든 작업에 일반화되는 문장은 아니다.
3. 진짜 혁신은 '비용 페널티 강화학습'
기술적으로 가장 흥미로운 부분은 학습 방식이다. 코그니션은 보상 함수에 비용 항을 페널티로 넣었다. 공개된 형태는 다음과 같다.
R = S − λ·C
S는 과제 성공 점수, C는 그 과제를 푸는 데 든 비용, λ는 가중치다. 모델은 "맞히기만 하면 된다"가 아니라 "싸게 맞혀야 보상이 크다"를 학습한다.
이 접근의 어려운 점은 따로 있다. 비용에 페널티를 주면 모델이 게을러지기 쉽다. 어려운 문제를 제대로 붙들지 않고 대충 끝내는 쪽으로 수렴해버린다. 코그니션은 이 붕괴를 피하면서 각 추론 노력(reasoning effort) 구간을 개별적으로 개선했다고 설명한다. 즉 저비용 구간이 좋아지느라 고비용 구간이 망가지는 트레이드오프를 피했다는 주장이다.
SWE-2는 추론 노력을 medium / high / max 세 단계로 제공한다. 실행 통계는 이렇다.
| 구분 | 실행당 평균 스텝 수 |
| SWE-1.7 (이전 모델) | 127 |
| SWE-2 medium | 53 |
| SWE-2 high | 80 |
| SWE-2 max | 98 |
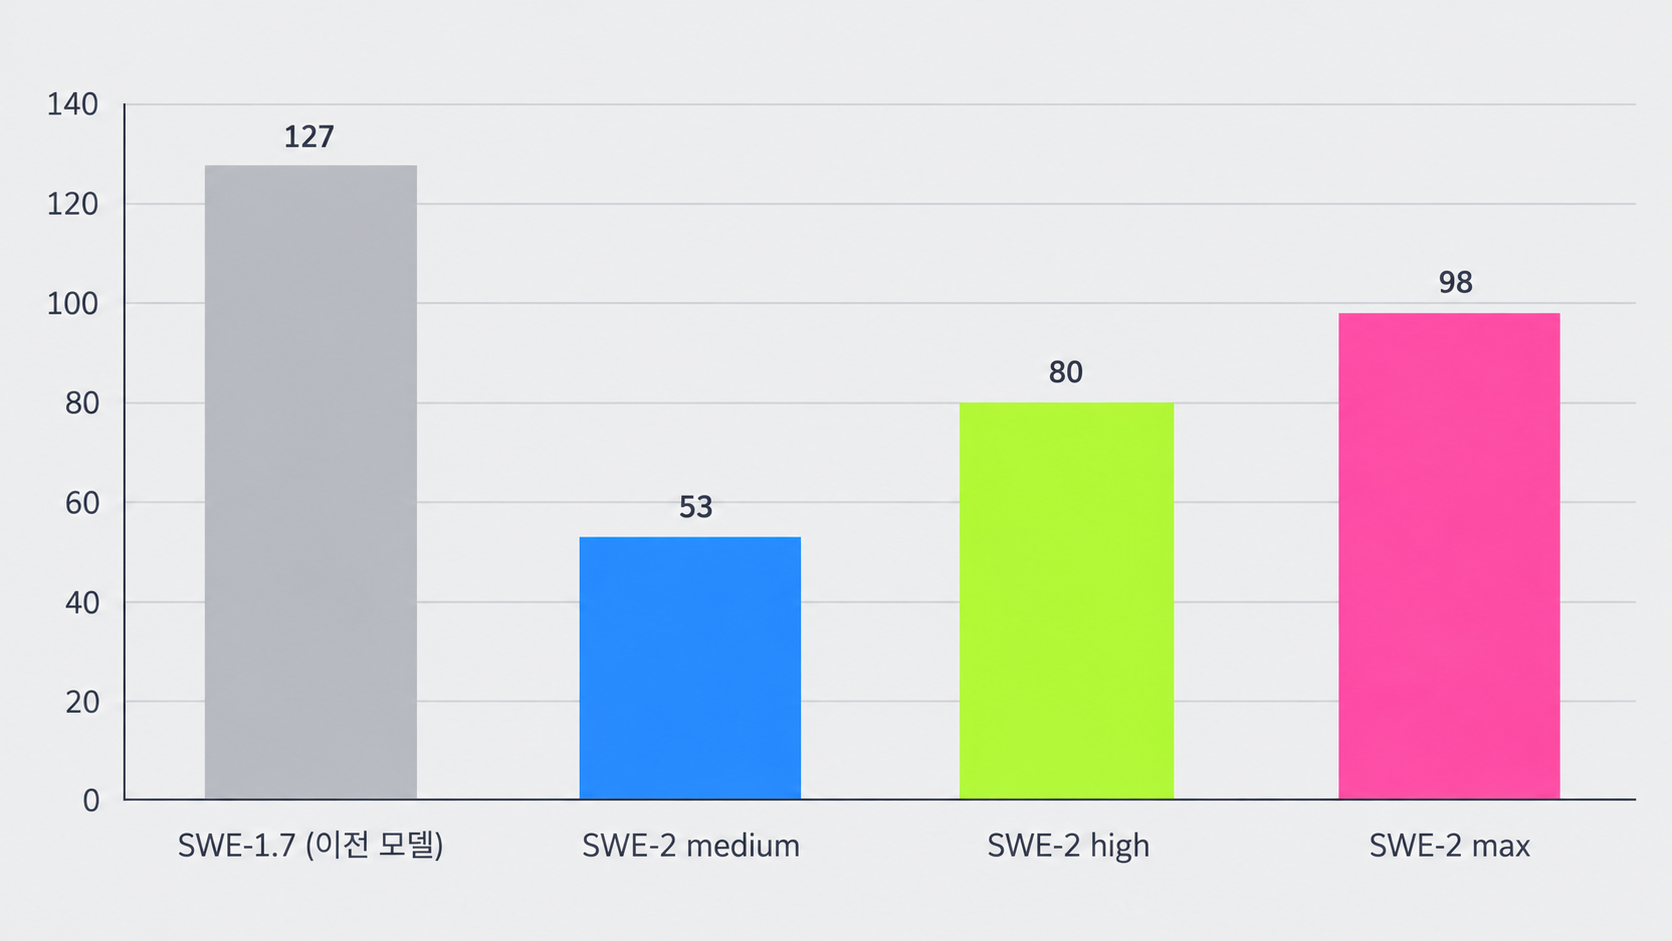
첫 코드 수정까지 도달하는 중앙값 스텝 수는 더 극적이다. SWE-1.7이 48스텝인 데 비해 SWE-2 medium은 18스텝이다. 탐색을 덜 하고 더 빨리 손을 댄다. 종합하면 코그니션의 주장은 이것이다. SWE-2 medium은 FrontierCode에서 SWE-1.7을 능가하면서, 에이전트 스텝을 58% 줄이고 실행당 평균 비용을 81% 낮췄다.
실무자 관점에서 이 수치가 의미하는 바는 분명하다. 에이전트 비용의 대부분은 모델 단가가 아니라 스텝 수 × 컨텍스트 누적에서 나온다. 같은 단가라도 스텝이 절반이면 비용은 절반 이하로 떨어진다. 컨텍스트가 매 턴 누적되기 때문이다. 코딩 에이전트 최적화의 핵심이 '더 똑똑한 모델'이 아니라 '덜 헤매는 모델'이라는 점을 이번 릴리스가 수치로 보여줬다.
4. 배포 방식 — 닫힌 쪽을 택했다
여기서 호불호가 갈릴 부분이 나온다.
- 가중치 공개 없음. 오픈웨이트 베이스를 썼지만 결과물은 공개하지 않는다.
- 독립 API 없음. 다른 도구에 붙여 쓸 수 없다.
- 데빈 전용. 출시 시점 기준 데빈 데스크톱과 데빈 CLI에서 제공되며, 데빈 웹과 퓨전(Fusion)은 순차 적용 예정이다.
- 2026년 10월 10일까지 유료 데빈 티어에서 무료 제공.
즉 SWE-2는 '모델 제품'이 아니라 제품을 싸게 돌리기 위한 내부 엔진이다. 코그니션의 비즈니스 모델이 모델 판매가 아니라 에이전트 구독이므로, 추론 비용 절감은 그대로 마진 개선이 된다. 모델을 팔지 않는 회사가 모델을 만드는 이유가 여기 있다.
이 전략에는 명확한 리스크도 있다. 베이스 모델을 외부(문샷AI)에 의존하고 있고, 자체 API가 없으니 개발자 생태계가 형성되지 않는다. 데빈이라는 제품 하나의 경쟁력에 모델 투자 전체가 종속되는 구조다.
5. 이 릴리스가 가리키는 방향
정리하면 세 가지 흐름이 보인다.
첫째, 애플리케이션 기업의 수직 통합. 코딩 도구 회사가 자기 모델을 후속 학습해 원가를 통제하는 패턴이 굳어지고 있다. 상위 모델 API에 마진을 내주는 구조에서 벗어나려는 시도다.
둘째, 오픈웨이트 베이스의 전략적 가치 상승. 2.8조 파라미터급 베이스를 외부에서 조달할 수 있다는 사실 자체가 게임의 규칙을 바꿨다. 사전학습에 수천억 원을 쓰지 않고도 프런티어 근처에 도달하는 경로가 열렸다.
셋째, 평가 기준의 이동. 앞으로 코딩 모델 비교표에는 정확도만 나오지 않을 것이다. 정확도 / 실행당 스텝 수 / 실행당 비용이 함께 나와야 의미 있는 비교가 된다. 이번 릴리스는 그 관행을 밀어붙인 사례다.
개인적으로 가장 눈여겨보는 건 Terminal-Bench 4 점수다. 저 격차가 다음 버전에서 좁혀지는지가, 비용 최적화가 '진짜 효율'인지 아니면 '어려운 문제를 포기한 대가'인지를 가르는 기준이 될 것이다.
'AI STUDY > ISSUE' 카테고리의 다른 글
| Claude Fable 5.1 암호 해독 총정리 — 370년 난제 44분 돌파, 그리고 "그 암호는 책에 없다"는 반박까지 (0) | 2026.09.15 |
|---|---|
| Claude Code 주간 사용량 17% 축소 총정리 — "25% 인상"인데 왜 줄었나, 한도 아끼는 실전 세팅까지 (0) | 2026.09.15 |
| 애덤 레인 법 캘리포니아 서명 완료 — 미성년자 AI 챗봇 규제 내용 총정리 (0) | 2026.09.14 |
| GPT-6 아스트라 총정리 - 가격, 벤치마크, 사이버보안 '중대' 등급까지 (0) | 2026.09.13 |
| 앤트로픽 AI 오남용 리포트 정리 - 침해에 2시간, API 키가 전리품이 된 이유 (0) | 2026.09.13 |