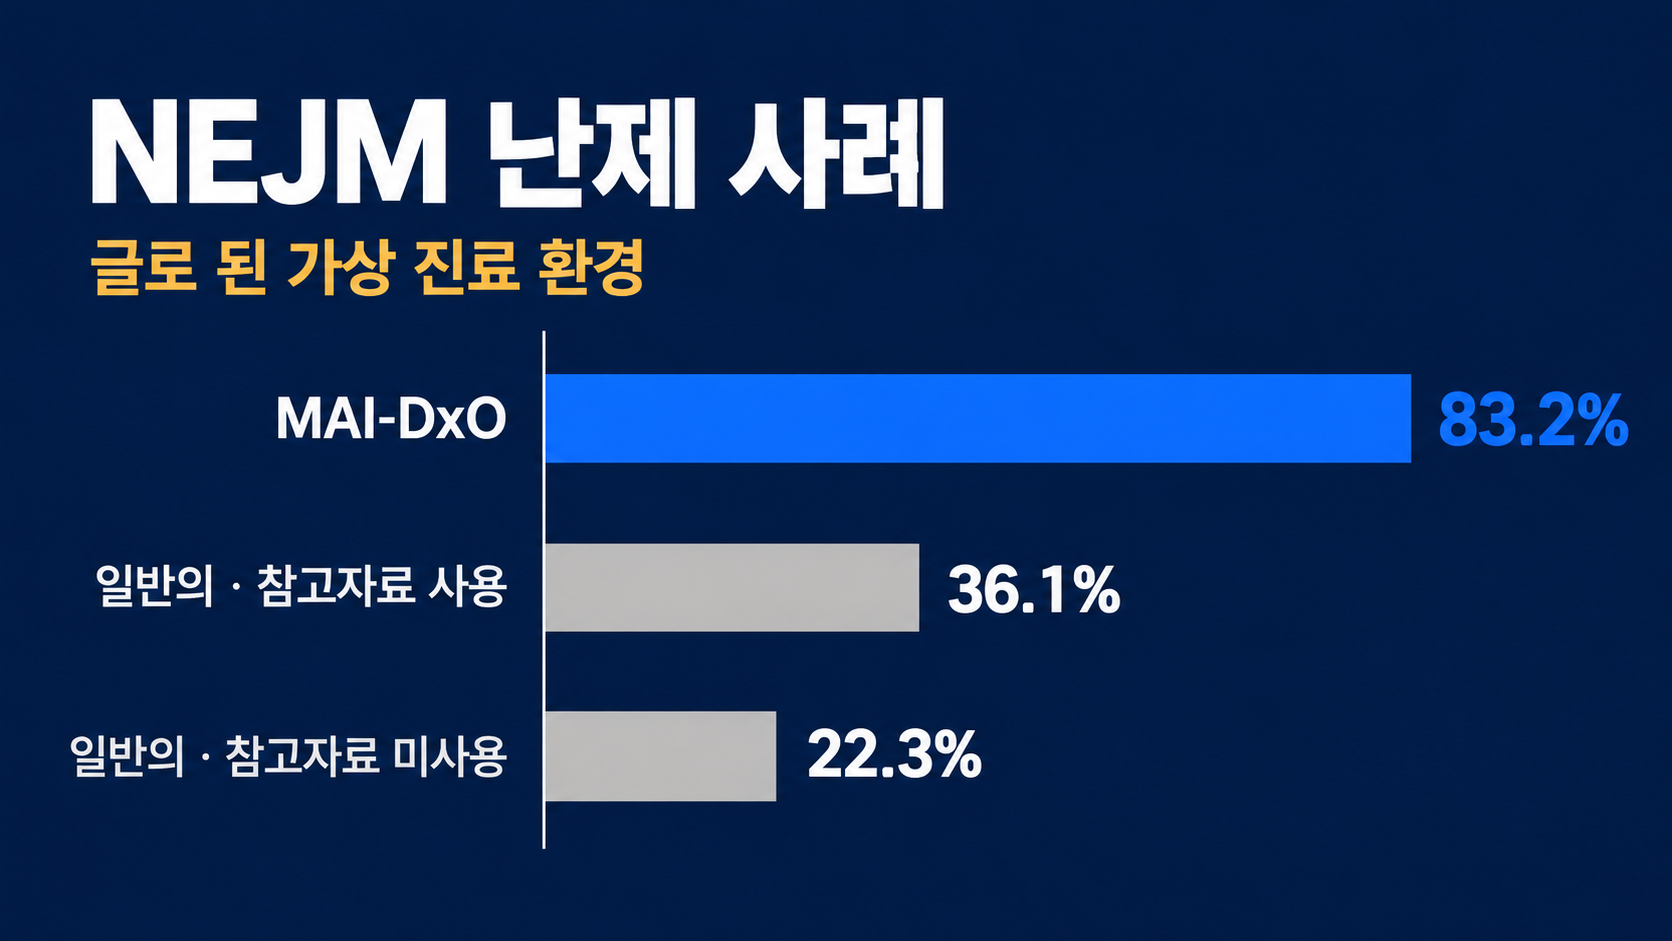
마이크로소프트 AI 진단 시스템 MAI-DxO가 미국 의학 학술지 NEJM의 난제 사례로 만든 시험에서 83.2%를 맞혔고, 같은 사례를 푼 일반의는 참고자료를 쓸 때 36.1%, 쓰지 않을 때 22.3%였다고 한다(Science, 2026-10-22). 다만 이 숫자는 글로 된 가상 진료 환경에서 개별 일반의와 비교한 결과다. MAI-DxO는 아직 일반인이 쓸 수 있는 제품이 아니고, 한국에서도 이용할 수 없다.
| 항목 | 내용 |
| 발표일 | 2026-10-22(현지시간), Science 394권 6822호 게재 |
| 발표 주체 | 마이크로소프트 AI(MAI) 헬스팀, 교신저자 하르샤 노리·에릭 호비츠 |
| 무엇이 발표됐나 | 순차 진단 벤치마크 SDBench와 AI 진단 오케스트레이터 MAI-DxO 동료 심사 논문 |
| 핵심 수치 | NEJM 난제 사례 83.2% vs 일반의 36.1%(참고자료 사용)·22.3%(미사용), 응급실 사례 80.3% vs 46.8% |
| 가격·요금 | 해당 없음(판매·구독 제품 아님) |
| 국내 이용 가능 여부 | 불가. 연구용 시스템이며 공개 출시 발표 없음 |
| 출처(공식) | Science 논문(doi 10.1126/science.aeh7930), Microsoft AI 공식 블로그 |
논문·서비스 정보 2026-10-24 기준. 연구 결과 해석과 서비스 상태는 이후 발표에 따라 바뀔 수 있다.
국내 기사 제목에는 "의사 36% vs AI 83%"가 주로 걸려 있는데, 이 숫자가 어떤 조건에서 나왔는지까지 같이 봐야 의미가 정확해진다. 그래서 이 글은 숫자를 어떻게 쟀는지부터 짚고, 비교 조건과 비용을 본 다음 반론과 실제 이용 가능 여부로 넘어간다.
MAI-DxO 사이언스 논문 핵심 수치: 83.2% vs 36.1%·22.3%
논문 제목은 「Sequential diagnosis with language models」이고, 2026년 4월 4일 접수돼 8월 10일 게재가 승인됐다. 핵심 결과는 두 갈래다. NEJM에 실린 매사추세츠 종합병원 증례 기록(CPC)에서 MAI-DxO는 83.2%를 맞혔고, 미국 응급실을 거쳐 입원한 환자 기록(MIMIC-IV-ED)에서는 80.3%를 맞혔다(Science, 2026-10-22).
같은 시험에서 일반의 평균은 CPC 36.1%, 응급실 사례 46.8%였다고 한다(Science, 2026-10-22). 마이크로소프트는 이를 두고 참고자료를 쓴 의사보다 약 2.3배, 쓰지 않은 의사보다 약 3.7배 정확했다고 설명했다(Microsoft AI 블로그, 2026-10-22). 응급실 사례에서는 그 차이가 1.7배로 줄어든다. 참가 의사 중 가장 잘한 사람도 CPC 51.8%에 그쳤는데, 이 의사보다도 MAI-DxO가 정확도와 비용 양쪽에서 앞섰다고 한다(Science, 2026-10-22).
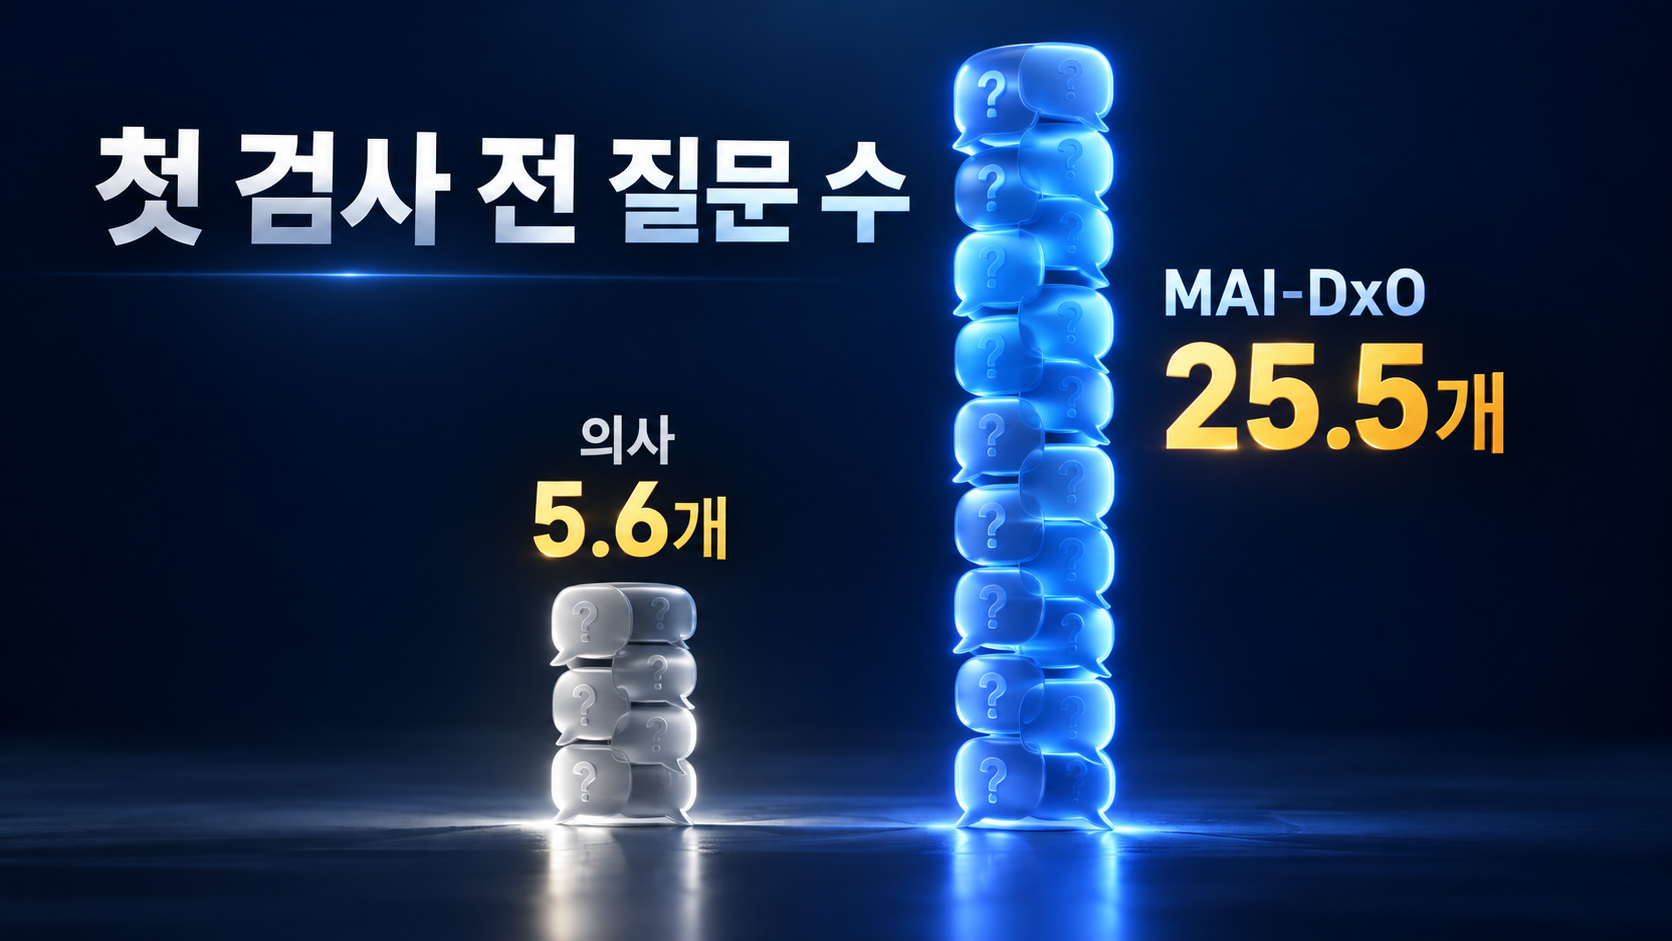
눈에 띄는 숫자가 하나 더 있다. 의사들은 첫 검사를 지시하기 전에 평균 5.6개 질문을 했지만, GPT-5를 쓴 MAI-DxO는 평균 25.5개 질문을 먼저 던졌다(Science, 2026-10-22). 검사보다 문진을 길게 가져가는 방식이다. 연구진은 여행 이력이나 드문 노출처럼 물어봐야 드러나는 단서가 필요한 사례에서 MAI-DxO가 기반 모델 단독보다 강했다고 분석했다.
AI 진단 정확도는 어떻게 쟀나: 순차 진단 벤치마크 SDBench
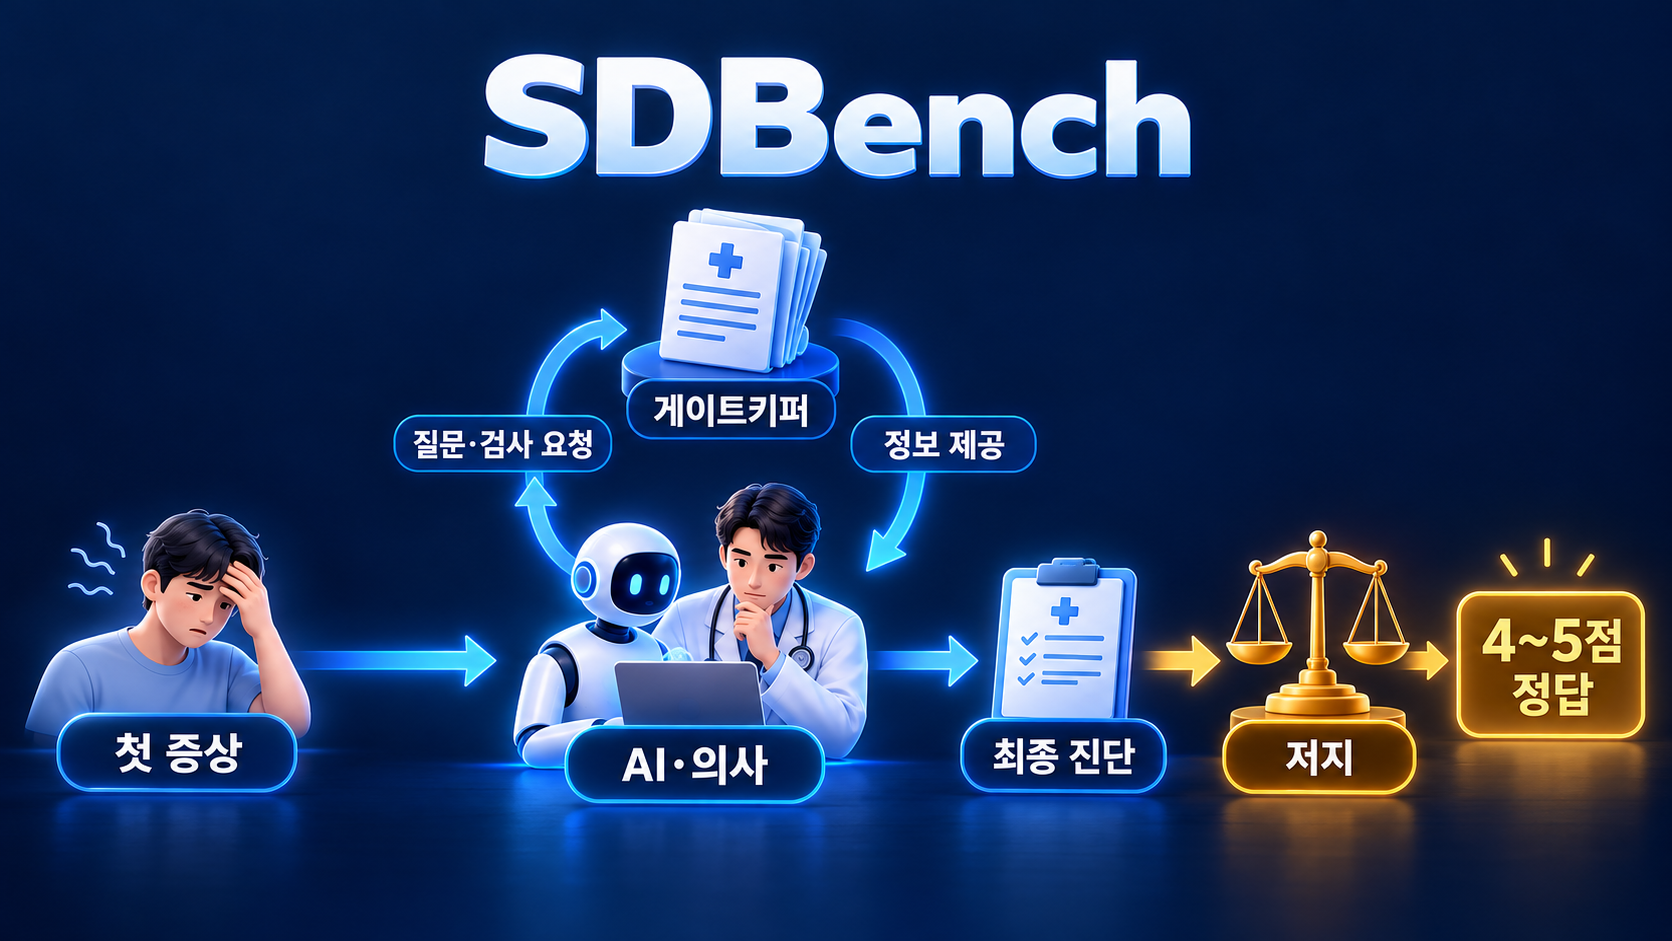
기존 의료 AI 평가는 대부분 증상·검사 결과를 한 번에 주고 정답을 고르게 하는 방식이었다. 연구진은 이런 시험이 "무엇을 물어볼지, 어떤 검사를 할지, 언제 결론을 낼지"를 재지 못한다고 보고 SDBench를 만들었다. NEJM CPC 304건과 응급실 입원 기록 325건을 단계별 진료 상황으로 바꾼 벤치마크다.
진행 방식은 이렇다. AI든 의사든 짧은 첫 증상 설명만 받은 채 시작한다. 이후 병력을 묻거나 검사를 요청하면 '게이트키퍼'라는 AI가 원래 증례 기록에서 해당 정보만 꺼내 준다. 기록에 없는 검사를 요청하면 정답 힌트가 되지 않도록 중립 결과를 만들어 준다고 한다.
최종 진단은 '저지(Judge)' 에이전트가 의사들이 만든 5단계 기준으로 채점한다. 4~5점, 즉 치료 방침이 달라지지 않을 수준이면 정답으로 쳤다. 의사와 AI가 똑같은 화면, 똑같은 규칙으로 시험을 치렀다는 점이 이 벤치마크의 특징이다.
또, MAI-DxO 자체는 새 AI 모델이 아니다. 기존 언어 모델 위에 얹는 '오케스트레이터'로, 가상 의사 여러 명이 역할을 나눠 감별 진단을 세우고 서로 반박하게 만든다. 검사를 고를 때는 진단에 보탬이 되는 정도와 비용을 함께 따진다고 한다. 논문 본문 결과는 오픈AI GPT-5를 기반으로 했고, 처음 개발할 때는 GPT-4.1이 기준이었다고 한다.
진단 비용까지 잰 이유와 숫자
이 연구가 다른 의료 AI 시험과 다른 지점은 비용이다. 검사를 많이 시킬수록 정답률이 오르는 건 당연하니, 정확도와 함께 누적 검사 비용을 같이 쟀다. 비용은 미국 카이저 퍼머넌트 워싱턴 병원이 공개한 표준 가격표(CPT 코드 기준)로 추산했다. 실제 청구서 금액은 아니다.
예산 제한 없이 돌린 MAI-DxO는 CPC 사례 1건당 평균 5,431달러를 썼다(Science, 2026-10-22). 참고자료를 쓴 의사 평균은 4,725달러, 쓰지 않은 의사는 3,049달러였다. 그러니까 83.2%라는 최고 정확도 설정에서는 AI 쪽 검사비가 오히려 조금 더 높았다.
그런데 예산을 걸면 숫자가 달라진다. 80.9% 정확도에 평균 2,241달러, 79.6%에 1,303달러까지 내려갔다고 한다(Science, 2026-10-22). 마이크로소프트가 말한 "의사 대비 절반에서 3분의 1 비용"은 이런 비용 절약 설정을 가리키는 것으로 보인다. 반대로 정확도를 최대로 끌어올린 설정은 84.5%에 8,945달러였다.
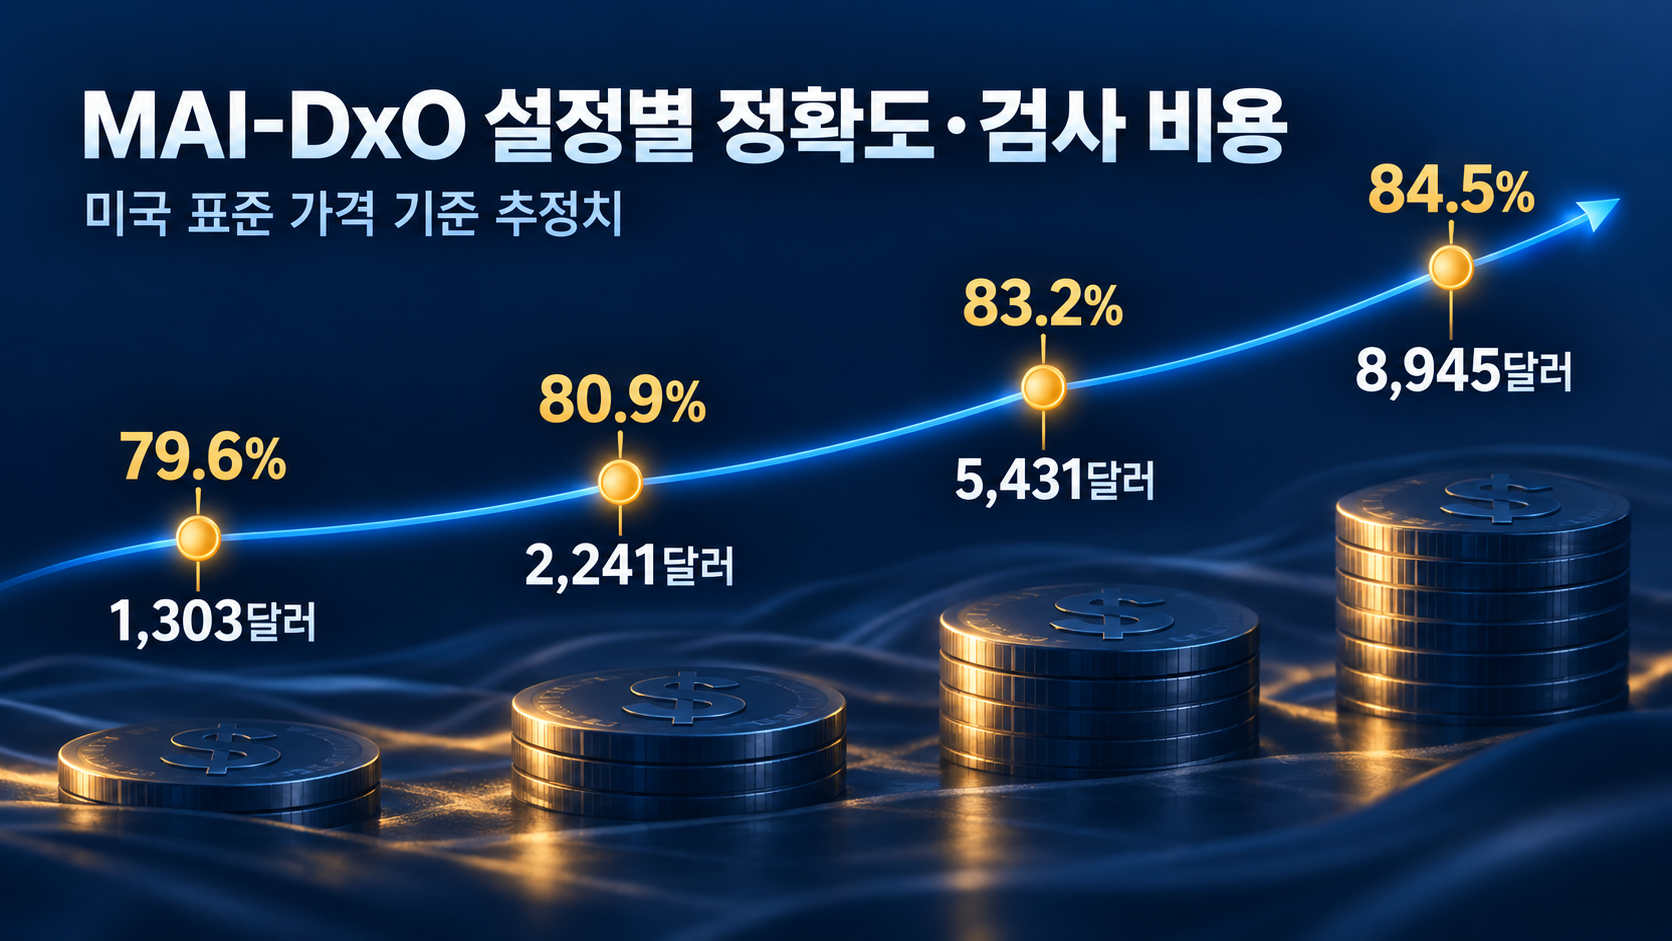
응급실 사례에서는 MAI-DxO가 80.3%에 평균 4,979달러, 의사는 46.8%에 3,400달러였다(Science, 2026-10-22). 기사에서 "더 정확하고 더 싸다"는 문장만 보면 오해하기 쉬운 부분이라 설정별로 따로 보는 편이 정확하다.
의사 vs AI 진단 비교 조건: 누가, 어떤 조건으로 참여했나
비교에 참여한 의사는 미국·영국에서 일하는 일차진료의와 병원 일반의(내과, 응급 등 포함)다. 전문의 협진팀은 들어가지 않았다. 의사 시험은 개발 과정에서 따로 빼둔 CPC 56건으로 진행됐고, 의사 한 명이 평균 35건 안팎을 풀어 참고자료 미사용 764건, 사용 662건의 진단이 모였다고 한다(Science, 2026-10-22).
참가 인원은 사이언스 본문에는 나오지 않는다. 2025년 11월 8일 날짜가 적힌 저자 공개 논문 수정본을 보면 참고자료 미사용 시험에는 21명(경력 중앙값 12년)이 참여했다. 사용 시험은 별도의 19명이 치렀고, 응급실 사례 시험은 이 중 16명이 맡았다고 적혀 있다. 미사용 시험에서는 검색엔진과 생성형 AI를 금지했고, 사용 시험에서는 UpToDate, NICE 가이드라인 같은 임상 참고 도구만 허용하고 챗GPT 같은 생성형 AI는 뺐다고 한다. 사이언스 최종본 부록의 인원이 이 수정본과 같은지는 확인하지 못했다.
시간도 차이가 있었다. 의사들은 한 사례에 평균 11.9분(미사용)과 18.1분(사용)을 썼다(Science, 2026-10-22). 시간제한은 없었지만, 실제 진료처럼 동료에게 묻거나 환자를 직접 보는 과정은 없었다.
하나 더 짚을 부분이 있다. 의사 비교는 56건으로 했는데, MAI-DxO의 83.2%가 304건 전체 기준인지 같은 56건 기준인지는 논문 본문만으로는 분명하지 않다. 해외 기사 중에는 "304건 중 83.2%"로 쓴 곳도 있지만, 공식 부록에서 확인되기 전까지는 "NEJM 사례 기준 83.2%" 정도로 읽는 편이 안전하다.
2025년 프리프린트와 이번 사이언스 논문의 차이
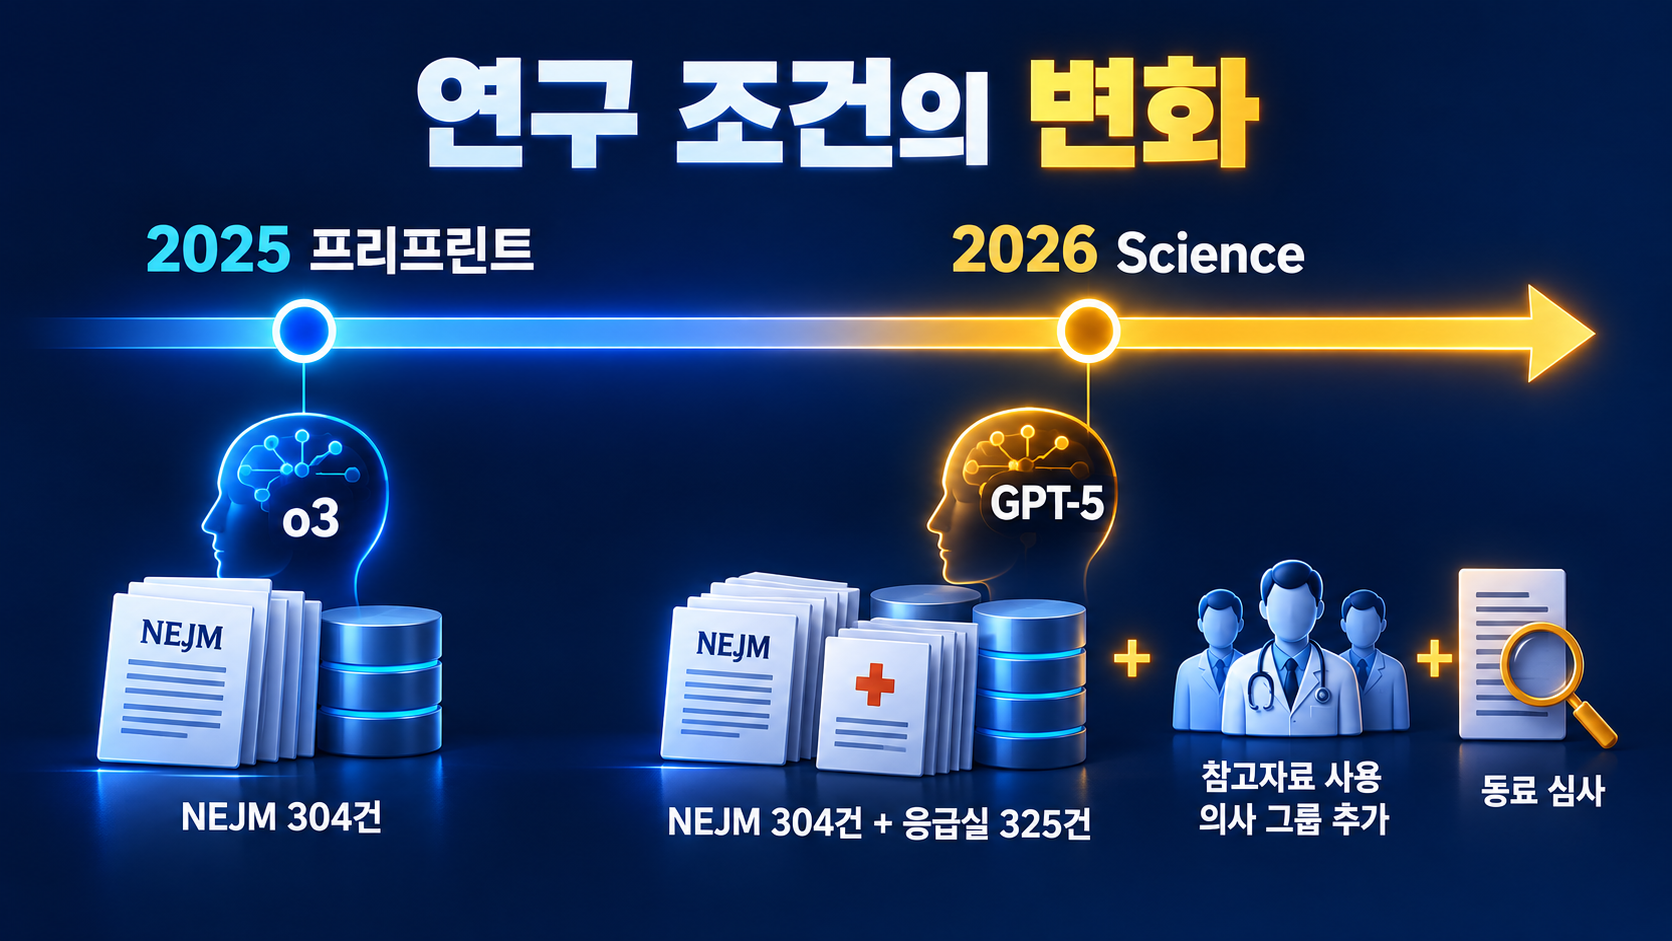
MAI-DxO는 2025년 6월 arXiv 프리프린트로 먼저 공개됐다. 당시에는 오픈AI o3 모델을 썼고, NEJM 사례 304건만 다뤘다. 결과는 MAI-DxO 80%, 일반의 21명 평균 20%였고, 최대 정확도 설정은 85.5%였다(arXiv 2506.22405, 2025-06-27). 검사비는 의사보다 20%, o3 단독보다 70% 줄었다고 발표했다.
이번 사이언스 게재본에서 바뀐 점은 크게 넷이다.
- 기반 모델이 o3에서 GPT-5로 바뀌었고, 게재 직전 GPT-5.5로 같은 평가를 다시 돌렸다.
- 응급실 입원 기록 325건이 새로 들어가 일상에 가까운 사례에서도 검증했다.
- 참고자료를 쓰는 의사 그룹이 추가돼 비교 조건이 두 가지가 됐다.
- 외부 동료 심사를 거친 정식 논문이 됐다.
그래서 "작년엔 85.5%였는데 왜 83.2%로 내려갔나"라는 질문은 조건이 달라서 생긴 차이로 봐야 한다. 기반 모델부터 사례 구성까지 달라졌기 때문에 두 숫자를 직접 비교하기는 어렵다.
마이크로소프트 의료 AI를 둘러싼 한계와 반론
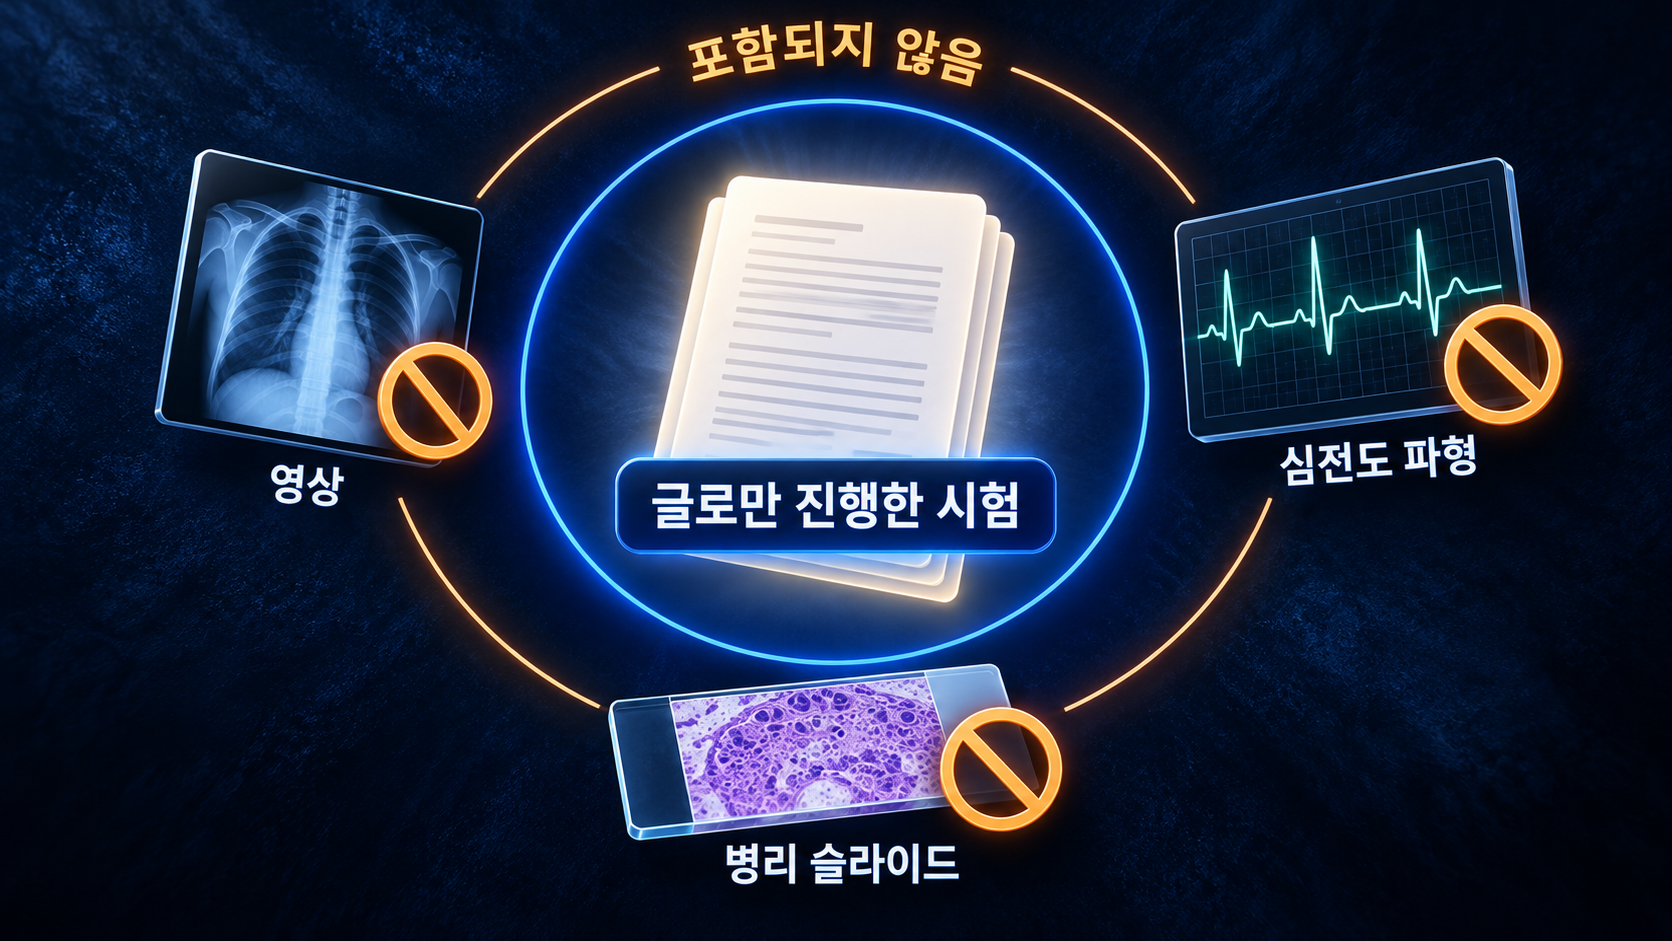
논문 스스로 밝힌 한계부터 보면, 시험은 글로만 진행됐고 영상·심전도 파형·병리 슬라이드 같은 자료는 없었다. 건강하거나 가벼운 사례는 빠져 있어 실제 외래 환자 구성과 다르다. 비용은 미국 표준 가격 기준이라 다른 나라 의료비와는 맞지 않을 수 있고, 저지는 진단명만 채점할 뿐 치료가 적절했는지나 안전성은 보지 않는다(Science, 2026-10-22).
비교 대상에 대한 지적도 있다. 이런 난제 사례는 보통 전문의나 협진팀이 맡는데, 이들이 비교에 없었다는 점이다(TechCrunch, 2026-10-22). 연구진도 전문의나 다학제 팀과 비교하면 격차가 줄어들 것이라고 논문에 적었다. 모의실험에서 나온 성적이라는 점을 고려해야 한다는 지적도 국내 보도에 실렸다(지디넷코리아, 2026-10-23).
성능의 상당 부분이 기반 모델 덕이라는 반론도 나왔다. TechCrunch에 따르면 GPT-5에 짧은 기본 지시문만 줬을 때 CPC 정확도가 이미 78.9%였고, MAI-DxO를 얹어 오른 폭은 약 4%포인트였다. 응급실 사례에서는 정확도와 비용 모두 개선이 거의 없었다고 한다. 논문 집계로도 여러 모델에 걸친 평균 향상 폭은 CPC 7.9%포인트, 응급실 4.4%포인트였다(Science, 2026-10-22).
이해관계도 같이 알아두면 좋다. 논문 저자 전원이 마이크로소프트 직원이고 회사 지분을 갖고 있으며, 연구비도 마이크로소프트 외부 자금이 없었다고 논문에 밝혀져 있다. 무스타파 술레이만 마이크로소프트 AI CEO는 이번 결과를 "의료 초지능"으로 가는 한 걸음이라고 표현했다(TechCrunch, 2026-10-22).
MAI-DxO 일반인이 지금 쓸 수 있나
결론부터 말하면 쓸 수 없다. 마이크로소프트는 2025년 6월 공식 블로그에서 SDBench와 MAI-DxO를 "연구 시연"이라고 밝혔고, 임상 사용 승인도 받지 않았다고 적었다. 2026년 10월 22일 발표에도 출시나 API 계획은 나오지 않았고, SDBench 일부 NEJM 사례와 평가 코드를 연구용으로 공개한다는 내용만 있었다.
코파일럿(Copilot)에 들어갔다는 공식 발표도 찾지 못했다. 2026년 3월 공개된 '코파일럿 헬스(Copilot Health)'는 별개 서비스로, 미국 거주 18세 이상 대상이며 질병을 진단·치료하기 위한 용도가 아니라고 마이크로소프트가 명시했다. 한국어 지원이나 국내 출시 일정도 발표되지 않았다.
다음 단계는 실제 병원 검증이다. 마이크로소프트는 보스턴 베스 이스라엘 디코니스 메디컬센터와 손잡고 전향 연구를 할 계획이라고 밝혔다. 동의한 환자가 평소대로 진료를 받으면서 MAI-DxO와도 따로 대화하고, AI가 낸 판단을 의료진의 독립 판단과 비교하는 방식이라고 한다. 아직 결과는 나오지 않았다.
독자 입장에서 달라지는 점을 정리하면 이렇다. 당장 쓸 수 있는 새 기능이나 비용 변화는 없다. 챗GPT나 코파일럿 같은 일반 챗봇에 증상을 물어보는 것은 이번 연구의 MAI-DxO와 다른 환경이고, 이번 결과를 근거로 그 답의 정확도를 짐작하기도 어렵다. AI 진단 결과는 의사의 진료와 판단을 대신하는 용도로 쓰면 안 되고, 몸에 이상이 느껴지면 의료기관에서 상담을 받는 게 맞다.
마이크로소프트 AI 진단 자주 묻는 질문
MAI-DxO 한국에서도 쓸 수 있나요?
쓸 수 없다. 2026년 10월 24일 기준 연구용 시스템이고 공개 출시나 국내 서비스 발표가 없다.
AI 진단 정확도 83%면 의사보다 낫다는 뜻인가요?
글로 진행한 시험에서 개별 일반의보다 높았다는 뜻이다. 전문의·협진팀과는 비교하지 않았고 실제 진료 성적도 아직 없다.
MAI-DxO는 코파일럿에 들어가 있나요?
공식 발표는 없다. 코파일럿 헬스는 별개 서비스이며 마이크로소프트는 진단 용도가 아니라고 밝혔다.
베스 이스라엘 디코니스 전향 연구 결과가 나오면, 83.2%라는 숫자가 실제 진료실에서 어디까지 유지되는지가 다음 관전 포인트가 될 것 같다.
AI 진단 결과를 의사 상담 전에 참고용으로라도 볼 생각이 있는지 댓글로 의견을 남겨주면 좋겠다.
출처
- Science, "Sequential diagnosis with language models" (2026-10-22): https://www.science.org/doi/10.1126/science.aeh7930
- Microsoft AI, "Building Medical Superintelligence" (2026-10-22): https://microsoft.ai/news/building-medical-superintelligence
- Microsoft AI, "The Path to Medical Superintelligence" (2025-06-30): https://microsoft.ai/news/the-path-to-medical-superintelligence/
- arXiv, "Sequential Diagnosis with Language Models" 2506.22405 (2025-06-27): https://arxiv.org/abs/2506.22405
- 논문 수정본 PDF (2025-11-08, 참가 의사 수·조건): https://www.erichorvitz.com/sequential_diagnosis_LM.pdf
- Microsoft AI, "Introducing Copilot Health" (2026-03-12): https://microsoft.ai/news/introducing-copilot-health/
- TechCrunch, "Microsoft's Mustafa Suleyman says its AI outperforms doctors on hard cases..." (2026-10-22): https://techcrunch.com/2026/10/22/microsofts-mustafa-suleyman-says-its-ai-outperforms-doctors-on-hard-cases-as-he-chases-medical-superintelligence/
- The Next Web, "Microsoft AI tool beat generalist doctors at step-by-step diagnosis" (2026-10-23): https://thenextweb.com/news/microsoft-ai-diagnosis-mai-dxo-science-study
- 지디넷코리아, "마이크로소프트, '의료 초지능' 개발 속도…'AI끼리 협업해 진단'" (2026-10-23): https://zdnet.co.kr/view?no=20261023094229
'AI STUDY > ISSUE' 카테고리의 다른 글
| Cursor Computer Use 정리, Claude Code·ChatGPT와 비교한 5가지 차이 (0) | 2026.10.25 |
|---|---|
| 클로드 MCP Tasks·엘리시테이션 지원, 달라진 점 3가지 정리 (0) | 2026.10.24 |
| 클로드 듀엣 정리, 승인 받는 행동 4가지와 막힌 행동 2가지 (0) | 2026.10.23 |
| Meta Muse 공유 대화 6,800건 노출, AI 대화 공유 링크 점검법 (0) | 2026.10.22 |
| 구글 하네스2, 모델은 그대로 두고 점수 11.5점 올린 방법 정리 (0) | 2026.10.22 |